İçindekiler
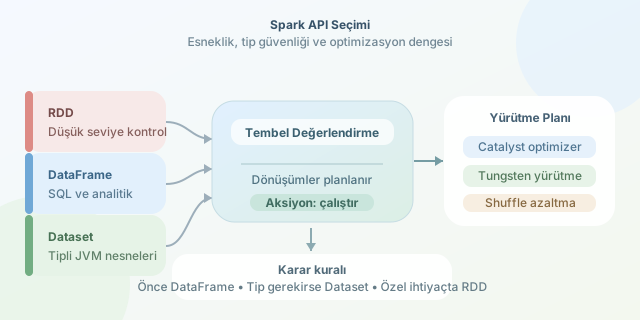
Apache Spark geliştiren herkesin karşısına aynı üçlü çıkar: RDD, DataFrame ve Dataset. Üçü de dağıtık veri işlemenin farklı yüzleridir; ancak soyutlama seviyesi yükseldikçe kod yazma deneyimi, tip güvenliği ve sorgu optimizasyonu da değişir. Doğru API seçimi yalnızca birkaç milisaniye kazanmak değildir: ekibin bakım maliyetini, hata ayıklama süresini ve küme kaynaklarının verimli kullanımını doğrudan etkiler.
``
Önce ortak zemini kuralım. Spark, işlemleri lazy evaluation ile planlar; yani map, filter veya select çağrıları anında hesaplanmaz. Bir count, write ya da collect aksiyonu geldiğinde Spark bir yürütme planı oluşturur. RDD tarafında geliştirici dönüşüm zincirini daha doğrudan tanımlar. DataFrame ve Dataset ise Spark SQL motorunun Catalyst optimizer ve Tungsten yürütme altyapısından faydalanır.
Basitleştirilmiş maliyet modeliyle bir işin süresini şöyle düşünebiliriz:
\[T_{toplam} = T_{okuma} + T_{shuffle} + T_{CPU} + T_{serileştirme}\]API seçimi özellikle $T_{CPU}$, $T_{shuffle}$ ve serileştirme maliyetlerini etkiler. DataFrame, sütun bazlı işlemler ve optimizasyon sayesinde çoğu analitik senaryoda RDD’den daha verimli olur. Dataset ise JVM dünyasında DataFrame’in planlama avantajını, nesne odaklı kodun tip güvenliğiyle birleştirmeyi hedefler.
| API | Veri modeli | Tip güvenliği | Catalyst optimizasyonu | En güçlü olduğu alan |
|---|---|---|---|---|
| RDD | Her tür JVM/Python nesnesi | Derleme zamanında sınırlı | Hayır | Düşük seviye, özel algoritmalar |
| DataFrame | İsimli sütunlardan oluşan tablo | Çalışma zamanında şema | Evet | SQL, ETL, raporlama |
| Dataset | Tipli JVM nesneleri | Evet (Scala/Java) | Evet | Alan modeli odaklı JVM uygulamaları |
RDD: Kontrol sizde, optimizasyon yükü de sizde
RDD, Spark’ın temel soyutlamasıdır. Bölümlere ayrılmış, değiştirilemez ve hata toleranslı koleksiyonlar sunar. Karmaşık kayıt tipleri, özel partitioner kullanımı veya graf/iteratif algoritmalar söz konusuysa hâlâ değerlidir. Fakat Spark, RDD içindeki nesnelerin anlamsal yapısını bilmediği için filter işlemini veri kaynağına itme ya da gereksiz sütunları eleme gibi optimizasyonlar yapamaz.
val errors = sc.textFile("/logs/app.log")
  .filter(_.contains("ERROR"))
  .map(line => line.split(" ").last)
  .countByValue()
Bu kod hata kodlarını sayar. Esnek görünse de her satır JVM nesnesine dönüşür; geniş veri kümelerinde nesne oluşturma ve garbage collection maliyetleri büyüyebilir.
DataFrame: Analitik işlerin varsayılan tercihi
DataFrame, satırları Row, veriyi ise şemalı sütunlar olarak temsil eder. Spark sütun ifadelerini anlayabildiğinden filtreleri erkenden uygulayabilir, yalnız gereken kolonları okuyabilir ve fiziksel planı yeniden düzenleyebilir. Python kullanan ekipler için ayrıca Dataset seçeneği olmadığından DataFrame doğal standarttır.
from pyspark.sql import functions as F

errors = (spark.read.json("/logs/events")
    .filter(F.col("level") == "ERROR")
    .groupBy("service")
    .count()
    .orderBy(F.desc("count")))
Burada Spark, JSON’dan yalnız kullanılan alanları okumaya ve filtreyi mümkün olduğunca erken çalıştırmaya çalışır. errors.explain() çağrısı fiziksel planı görerek bu varsayımı doğrulamanın harika yoludur.
Dataset: Tip güvenliği isteyen JVM ekipleri için
Dataset yalnızca Scala ve Java API’lerinde bulunur. case class Event(...) gibi tipli kayıtlara erişim, alan adındaki yazım hatalarının derleme aşamasında yakalanmasını sağlar. Ancak map ile sıkça nesneye dönmek, DataFrame’in sütun bazlı avantajını azaltabilir. Bu nedenle Dataset’te bile önce select, filter, groupBy gibi ifade tabanlı işlemleri tercih etmek akıllıcadır.
| İhtiyaç | Önerilen API | Neden |
|---|---|---|
| SQL benzeri ETL ve agregasyon | DataFrame | En iyi optimizer desteği |
| Python ile Spark geliştirme | DataFrame | Birincil ve olgun API |
| Özel veri yapısı veya düşük seviye kontrol | RDD | Maksimum esneklik |
| Scala/Java alan nesneleri | Dataset | Tip güvenliği ve okunabilirlik |
Kısa karar kuralı şudur: Önce DataFrame ile başlayın, tipli alan modeli gerçekten değer katıyorsa Dataset’e geçin, Spark SQL’in ifade edemediği özel bir ihtiyaç doğarsa RDD’ye inin. Ayrıca performansı tahmin etmek yerine explain, Spark UI ve gerçekçi veri hacmiyle ölçün. Çünkü dağıtık sistemlerde en hızlı API, çoğu zaman en az shuffle üreten API’dir.
Yorumlar