İçindekiler
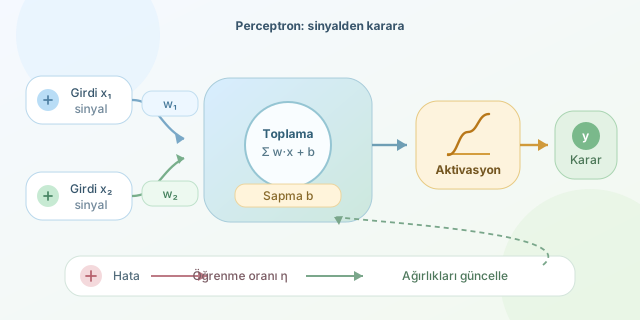
İnsan beyninin yaklaşık 86 milyar nörondan oluşan karmaşık yapısı, yapay zekânın en güçlü ilham kaynaklarından biridir. Yapay Sinir Ağları (Artificial Neural Networks, ANN), beynin birebir kopyası değildir; ancak nöronların bilgiyi alma, işleme ve iletme fikrini matematiksel bir çerçeveye taşır. Bu yaklaşımın en temel yapı taşı olan perceptron, sayısal girdilerden bir karar üretmeyi öğrenebilen dijital bir algılayıcıdır.
``
Biyolojik nörondan matematiksel modele
Biyolojik bir nöronun dendritleri diğer nöronlardan sinyal toplar. Hücre gövdesi bu sinyalleri değerlendirir; toplam etki yeterince güçlüyse akson üzerinden yeni bir elektriksel sinyal gönderilir. ANN dünyasında bu süreç, girdiler, ağırlıklar, toplama işlemi ve aktivasyon fonksiyonu ile modellenir.
| Biyolojik yapı | ANN karşılığı | Temel görevi |
|---|---|---|
| Dendrit | Girdi $x_i$ | Bilgiyi veya sinyali almak |
| Sinaps | Ağırlık $w_i$ | Girdinin etkisini belirlemek |
| Hücre gövdesi | Toplama birimi | Ağırlıklı sinyalleri birleştirmek |
| Akson | Çıktı $y$ | Kararı sonraki birime aktarmak |
Bir perceptron, her girdi için bir önem katsayısı öğrenir. Önce ağırlıklı toplam hesaplanır:
\[z = \sum_{i=1}^{n} w_i x_i + b\]Burada $x_i$ girdileri, $w_i$ ağırlıkları, $b$ ise bias (sapma) değerini temsil eder. Bias, karar sınırını orijinden kaydırır; yani modelin yalnızca sıfır merkezli örüntülere bağımlı kalmasını engeller. Sonrasında $z$ değeri bir aktivasyon fonksiyonundan geçirilir:
\[y = f(z)\]Klasik perceptronda sıkça basamak fonksiyonu kullanılır. Eğer $z \geq 0$ ise çıktı 1, aksi durumda 0 olur. Bu, “evet/hayır” türündeki sınıflandırma kararları için oldukça sezgiseldir.
Perceptron nasıl öğrenir?
Bir modelin başlangıçtaki ağırlıkları genellikle rastgele seçilir; dolayısıyla ilk tahminleri pek parlak olmayabilir. Öğrenme, modelin tahmini ile gerçek cevap arasındaki farktan doğar. Perceptron güncelleme kuralı şöyledir:
\[w_i \leftarrow w_i + \eta (t-y)x_i\]Burada $t$ hedef değer, $y$ model çıktısı ve $\eta$ öğrenme oranıdır. Model yanlış tahmin yaptığında ağırlıklar küçük adımlarla değiştirilir. Öğrenme oranı çok büyükse model hedefi ıskalayarak savrulabilir; çok küçükse öğrenme sabır testi hâline gelir.
| Kavram | Görevi | Çok düşük / yüksek olursa |
|---|---|---|
| Ağırlık | Girdinin önemini taşır | Model bazı ilişkileri kaçırabilir |
| Bias | Karar eşiğini ayarlar | Sınır gereksiz biçimde kısıtlanır |
| Öğrenme oranı $\eta$ | Güncelleme adımını belirler | Yavaş öğrenme / kararsız öğrenme |
| Aktivasyon | Çıktının biçimini seçer | Modelin ifade gücü değişir |
Python ile AND kapısını öğretmek
Aşağıdaki örnek, perceptronun mantıksal AND işlemini öğrenmesini simüle eder. AND kapısında yalnızca iki girdi de 1 olduğunda çıktı 1 olmalıdır.
import numpy as np

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
hedef = np.array([0, 0, 0, 1])
agirliklar = np.zeros(2)
bias = 0.0
ogrenme_orani = 0.1

def aktivasyon(deger):
    return 1 if deger >= 0 else 0

for epoch in range(20):
    for girdi, gercek in zip(X, hedef):
        tahmin = aktivasyon(np.dot(girdi, agirliklar) + bias)
        hata = gercek - tahmin
        agirliklar += ogrenme_orani * hata * girdi
        bias += ogrenme_orani * hata

for girdi in X:
    sonuc = aktivasyon(np.dot(girdi, agirliklar) + bias)
    print(f"{girdi} -> {sonuc}")
Kodda np.dot, $\sum w_i x_i$ işlemini yapar. Her eğitim örneğinden sonra hata hesaplanır ve ağırlıklarla bias güncellenir. Böylece perceptron, ezberlenmiş bir kural yerine örneklerden bir karar sınırı oluşturur.
Yine de tek katmanlı perceptronun önemli bir sınırı vardır: Yalnızca doğrusal olarak ayrılabilen problemleri çözebilir. XOR gibi örneklerde tek bir doğru ile sınıfları ayırmak mümkün değildir. İşte burada çok katmanlı ağlar, doğrusal olmayan aktivasyonlar ve geri yayılım algoritması sahneye çıkar. Kısacası perceptron küçük görünür; fakat modern derin öğrenmenin temel fikrini taşıyan oldukça büyük bir adımdır.
Yorumlar