İçindekiler
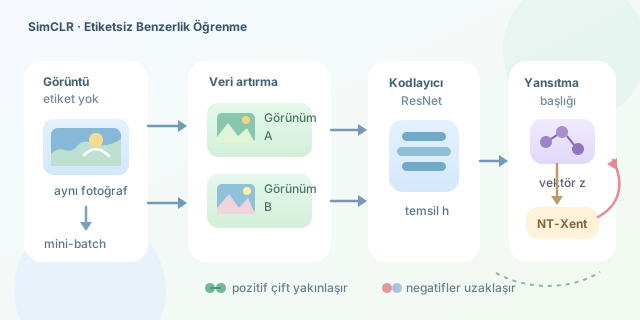
Bir makineye binlerce kedi fotoğrafı gösterdiğinizi, fakat hiçbirine “kedi” etiketi koymadığınızı düşünün. Makine yine de kulak, tüy ve yüz şekli gibi ortak özellikleri keşfedebilir mi? Contrastive Learning, yani karşılaştırmalı öğrenme, tam olarak bunu hedefler: Benzer örnekleri temsil uzayında birbirine yaklaştırır, farklı örnekleri ise uzaklaştırır. SimCLR da bu fikri şaşırtıcı derecede sade bir eğitim düzenine dönüştüren popüler yöntemlerden biridir. ``
Temel fikir: Etiket yerine karşılaştırma
Geleneksel denetimli öğrenmede model, bir görseli sınıf etiketiyle eşleştirir. Karşılaştırmalı öğrenmede ise “Bu nedir?” sorusundan önce “Bu iki görüntü aynı şeye mi ait?” sorusu sorulur. Böylece veri kendi eğitim sinyalini üretir.
Bir fotoğrafa rastgele kırpma, döndürme, renk değiştirme veya bulanıklaştırma uygulandığında iki farklı görünüm elde edilir. Bunlar pozitif çift kabul edilir. Aynı mini-batch içindeki diğer fotoğraflar ise genellikle negatif örneklerdir.
| Yaklaşım | Eğitim sinyali | Amaç | Etiket ihtiyacı |
|---|---|---|---|
| Denetimli öğrenme | İnsan tarafından verilen sınıf | Doğru sınıfı tahmin etmek | Yüksek |
| Contrastive Learning | Örnekler arasındaki ilişki | Yararlı temsil öğrenmek | Yok veya çok düşük |
| SimCLR | Artırılmış görüntü çiftleri | Aynı görüntünün görünümlerini yaklaştırmak | Yok |
Model, her görseli bir vektöre dönüştürür. İki temsil arasındaki benzerlik çoğunlukla kosinüs benzerliğiyle ölçülür:
\[sim(a,b) = \frac{a \cdot b}{\Vert a\Vert \,\Vert b\Vert }\]Vektörler aynı yönü gösteriyorsa sonuç 1’e yaklaşır; birbirlerinden farklı yönlerdeyse küçülür. Yani sistem, pikselleri ezberlemek yerine anlamlı bir geometrik harita oluşturmaya çalışır.
SimCLR nasıl çalışır?
SimCLR boru hattı dört temel parçadan oluşur:
- Batch içindeki her görüntüden iki rastgele görünüm üretilir.
- Görünümler, ResNet gibi bir encoder üzerinden geçirilerek $h$ temsilleri elde edilir.
- Küçük bir projection head, bu temsilleri $z$ uzayına taşır.
- Contrastive loss, pozitif çiftleri yaklaştırırken diğer örnekleri uzaklaştırır.
SimCLR’da sık kullanılan NT-Xent kaybının sadeleştirilmiş biçimi şöyledir:
\[L_{i,j} = -\log \frac{e^{sim(z_i,z_j)/t}}{\sum_{k \ne i} e^{sim(z_i,z_k)/t}}\]Buradaki $t$ sıcaklık parametresidir. Küçük sıcaklık, modelin benzerlik farklarına daha sert tepki vermesini sağlar. Pay kısmında pozitif eşleşme, paydada ise aday eşleşmeler bulunur. Kısacası modelden kalabalık içinde doğru “ikizi” bulması istenir.
PyTorch ile sade bir loss örneği
Aşağıdaki kod, iki görünümün temsillerini normalize eder ve doğru çiftleri çapraz entropiyle öne çıkarır:
import torch
import torch.nn.functional as F

def contrastive_loss(z1, z2, temperature=0.5):
    z1 = F.normalize(z1, dim=1)
    z2 = F.normalize(z2, dim=1)

    logits = z1 @ z2.T / temperature
    labels = torch.arange(z1.size(0), device=z1.device)

    loss_1 = F.cross_entropy(logits, labels)
    loss_2 = F.cross_entropy(logits.T, labels)
    return (loss_1 + loss_2) / 2
Matrisin köşegenindeki elemanlar doğru pozitif çiftlerdir. Fonksiyon iki yönü de hesaplayarak birinci görünümden ikinciyi ve ikinci görünümden birinciyi bulmayı öğretir. Gerçek SimCLR uygulamalarında aynı görünümün kendisiyle karşılaştırılması maskelenir ve batch içindeki tüm $2N$ temsil değerlendirilir.
Neden veri artırma bu kadar önemli?
Model yalnızca kırpılmış iki görüntüyü eşleştirirse konuma, yalnızca renk değişimini görürse renge bağımlı olabilir. Güçlü ve çeşitli dönüşümler, modele “Renk değişse de nesne aynı kalabilir” fikrini öğretir.
| Dönüşüm | Öğretilen dayanıklılık | Olası risk |
|---|---|---|
| Rastgele kırpma | Konum ve ölçek değişimi | Ana nesneyi kaybetmek |
| Renk bozma | Işık ve ton değişimi | Sınıfa ait renk bilgisini silmek |
| Bulanıklaştırma | Doku değişimi | İnce ayrıntıları yok etmek |
Eğitim tamamlandığında projection head genellikle atılır; encoder’dan çıkan temsiller sınıflandırma, benzer görsel arama veya kümeleme gibi görevlerde kullanılır. SimCLR’ın sihri aslında sihir değildir: İyi veri artırma, yeterince büyük batch ve doğru kayıp fonksiyonunun uyumlu çalışmasıdır. Etiketsiz bir fotoğraf arşivi böylece sessiz bir veri yığınından, kendi benzerlik dilini öğreten güçlü bir öğretmene dönüşür.
Yorumlar