İçindekiler
Her çatışmada aynı sandığın arkasına saklandığınızı düşünün. İlk karşılaşmada işe yarayan bu taktik, birkaç bölüm sonra düşmanların yandan yaklaşmasıyla bozuluyor. Acaba oyun sizi gerçekten tanıyor mu, yoksa iyi yazılmış kurallar mı sizi kandırıyor? Oyuncuya uyum sağlayan düşman yapay zekâsının güzelliği, bu iki yaklaşımın buluştuğu yerde başlıyor.
``
Öğrenmek ile tepki vermek aynı şey değil
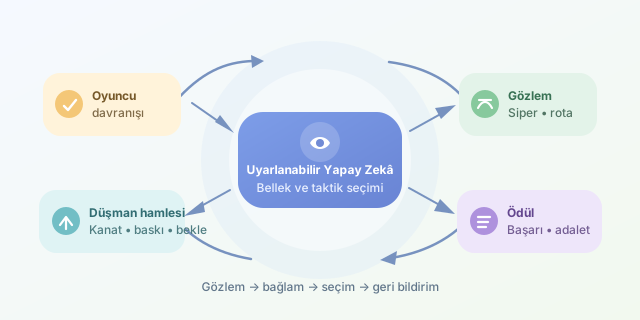
Bir düşmanın sizi görünce ateş etmesi öğrenme değildir. Bu, mevcut duruma verilen tepkidir. Öğrenen sistemde ise geçmiş gözlemler, gelecekteki kararları değiştirir. Sistem, oyuncunun sık kullandığı taktikleri temsil eden bir bellek tutar.
Ancak her uyarlanabilir düşman makine öğrenmesi kullanmaz. Tasarımcıların hazırladığı kurallar da oyuncu davranışına göre etkinleşebilir. Önemli ayrım, davranışın değişmesi değil, bu değişimi üreten mekanizmadır.
| Yaklaşım | Karar kaynağı | Oyuncuya uyum |
|---|---|---|
| Durum makinesi | Önceden tanımlanmış geçişler | Genellikle sınırlı |
| Davranış ağacı | Koşullar ve öncelikler | Bellekle genişletilebilir |
| Oyun direktörü | Tempo ve baskı ölçümleri | Deneyimi düzenler |
| Bağlamsal bandit | Bağlama göre ödül geçmişi | Taktik tercihlerini günceller |
Oyuncu tarzını sayılara çevirmek
Önce gözlemlenebilir özellikler gerekir: siperde geçirilen süre, yakın dövüş sıklığı veya aynı güzergâhın kullanımı. Bunlar oyuncunun kişiliğini değil, oyun içindeki davranışını temsil eder.
Siper kullanımını yumuşatılmış bir ortalamayla izleyebiliriz:
\[p_t=(1-a)p_{t-1}+ax_t\]Burada $x_t$, gözlem sırasında oyuncu siperdeyse 1, değilse 0 olur. $0<a<1$ öğrenme hızını belirler. Küçük değer geçmişi uzun süre hatırlar; büyük değer yeni alışkanlıklara hızlı uyum sağlar. Böylece tek bir saklanma hareketi, oyuncuyu sonsuza kadar “kampçı” ilan etmez.
Gözlemleri sabit aralıklarla toplamak önemlidir. Kare hızına bağlı örnekleme, aynı davranışın farklı bilgisayarlarda farklı öğrenilmesine neden olabilir.
Oyunlarda gördüğümüz şey ne?
Left 4 Dead oyunlarındaki AI Director, oyuncuların durumuna göre karşılaşmaların temposunu düzenleyen yaklaşımın bilinen örneklerindendir. Bu, her zombinin bireysel olarak strateji öğrendiği anlamına gelmez.
Alien: Isolation ise davranış organizasyonu ve direktör katmanıyla takip edilme hissini güçlendirir. Buradan “uzaylı kesinlikle çevrimiçi sinir ağı eğitiyor” sonucu çıkaramayız. Uyarlanabilir deneyim, öğrenilmiş modeller kadar tasarlanmış sistemlerden de doğabilir.
Küçük bir öğrenen taktik seçici
Aşağıdaki Python örneği, iki bağlamda hamlelerin başarısını ayrı ayrı tutar. Bu bir bağlamsal bandit yaklaşımıdır; uzun vadeli durum geçişlerini modelleyen tam bir pekiştirmeli öğrenme sistemi değildir.
import random

class TacticLearner:
    def __init__(self, seed=42):
        self.rng = random.Random(seed)
        self.cover = 0.5
        self.values = {}

    def observe(self, in_cover):
        self.cover = 0.9 * self.cover + 0.1 * int(in_cover)

    def choose(self, allowed):
        if not allowed:
            raise ValueError("En az bir hamle gerekli")
        context = "siper" if self.cover > 0.6 else "hareket"
        scores = {a: self.values.get((context, a), 0.0)
                  for a in allowed}
        if self.rng.random() < 0.15:
            action = self.rng.choice(allowed)
        else:
            best = max(scores.values())
            action = self.rng.choice([a for a in allowed
                                      if scores[a] == best])
        return context, action

    def update(self, context, action, reward):
        key = (context, action)
        old = self.values.get(key, 0.0)
        reward = max(-1.0, min(1.0, reward))
        self.values[key] = old + 0.1 * (reward - old)
observe, siper eğilimini günceller. choose, örneğin yandan yaklaşma, baskılama ve bekleme arasından seçim yapar; yüzde 15 olasılıkla keşfe çıkar. update ise hamlenin sonucu belli olunca çağrılır. Dönen bağlamı saklamak gerekir: sonuç gecikince oyuncunun yeni bağlamına yanlış ödül yazmamalıyız.
En iyi düşman, en acımasız düşman değildir
Ödülü yalnızca verilen hasara bağlarsanız sistem bunaltıcı davranışları tercih edebilir. Bunun yerine anlamlı baskı oluşturmayı, taktik çeşitliliğini ve oyuncuya karşılık verme fırsatı bırakmayı değerlendirin. Eğlence doğrudan ölçülemediği için bu göstergeleri kullanıcı testleriyle doğrulayın.
allowed listesine yalnızca görüş, kaynak ve bekleme süresi açısından geçerli hamleler girmelidir. Düşman, oyuncunun duvar arkasındaki konumunu sihirli biçimde öğrenmemeli. Adaptasyonun işaretleri de okunabilir olmalı: telsiz konuşması veya kanat hareketi, değişen taktiği haber verebilir.
Son olarak sabit yapay zekâyla karşılaştırmalı test yapın. Başarı oranının yanında algılanan adaleti, tekrarları ve strateji çeşitliliğini ölçün. Oyuncu taktiğini değiştirdiğinde sistemin toparlanabildiğini de sınayın. Amaç oyuncuyu yenmek değil, onu yeni fikirler üretmeye davet etmektir.
Yorumlar