Bir sinir ağı ilk çalıştığında genellikle pek parlak değildir: kediyi köpek, 7’yi 1, hatta kahveyi çorba sanabilir. Onu zamanla iyileştiren mekanizma geri yayılımdır (backpropagation). Bu algoritma, ağın ürettiği hatayı çıkış katmanından girişe doğru dağıtır; her ağırlığın hataya ne kadar katkı yaptığını zincir kuralıyla hesaplar ve ağırlıkları doğru yönde günceller.
``
Problemin matematiksel modeli
Tek gizli katmanlı bir ağ düşünelim. Girdi vektörü $\mathbf{x}$, gizli katman ağırlıkları $W^{(1)}$, çıkış katmanı ağırlıkları ise $W^{(2)}$ olsun. İleri yayılımın adımları şunlardır:
\[\mathbf{z}^{(1)} = W^{(1)}\mathbf{x}+\mathbf{b}^{(1)}, \quad \mathbf{a}^{(1)} = f(\mathbf{z}^{(1)})\] \[z^{(2)} = W^{(2)}\mathbf{a}^{(1)}+b^{(2)}, \quad \hat{y}=g(z^{(2)})\]Burada $f$ gizli katmanın, $g$ ise çıkış katmanının aktivasyon fonksiyonudur. Gerçek hedef $y$ iken, karesel hata kaybı şu şekilde tanımlanabilir:
\[L = \frac{1}{2}(\hat{y}-y)^2\]Amaç yalnızca hatayı ölçmek değil, $L$ değerini küçültecek ağırlıkları bulmaktır. Bunun için her ağırlık bakımından türeve, yani gradyana ihtiyaç duyarız.
| Kavram | Anlamı | Ağdaki rolü |
|---|---|---|
| İleri yayılım | Girdiden tahmine ilerleme | $\hat{y}$ üretir |
| Kayıp fonksiyonu | Tahminin başarısızlığını ölçme | Öğrenilecek hedefi belirler |
| Gradyan | Hatanın değişim yönü | Güncellemenin pusulasıdır |
| Geri yayılım | Gradyanı katmanlara dağıtma | Suçun ağırlıklara paylaştırılmasıdır |
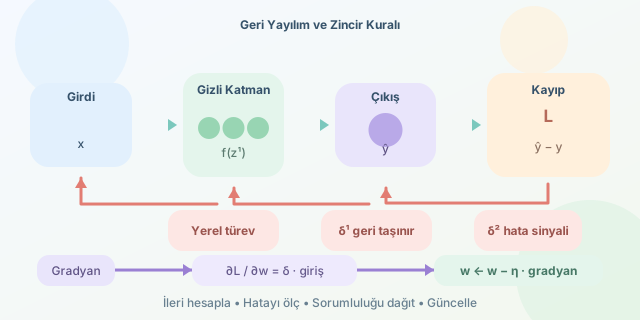
Zincir kuralı neden her şeyi çözer?
Çıkış ağırlığı $w_j^{(2)}$ için hata, dolaylı bir yoldan oluşur: ağırlık önce $z^{(2)}$ değerini, o da $\hat{y}$ tahminini, tahmin de kaybı etkiler. Zincir kuralı bu yolu çarpar:
\[\frac{\partial L}{\partial w_j^{(2)}} = \frac{\partial L}{\partial \hat{y}} \frac{\partial \hat{y}}{\partial z^{(2)}} \frac{\partial z^{(2)}}{\partial w_j^{(2)}}\]Karesel hata için $\frac{\partial L}{\partial \hat{y}}=\hat{y}-y$, aktivasyon için $\frac{\partial \hat{y}}{\partial z^{(2)}}=g’(z^{(2)})$ ve doğrusal toplama için $\frac{\partial z^{(2)}}{\partial w_j^{(2)}}=a_j^{(1)}$ olur. Dolayısıyla:
\[\frac{\partial L}{\partial w_j^{(2)}} = \delta^{(2)}a_j^{(1)}, \quad \delta^{(2)}=(\hat{y}-y)g'(z^{(2)})\]Bu, çıkış katmanının hata sinyalidir. Gizli katmana geçince aynı mantık sürer. Gizli nöron $j$, hatayı çıkışa bağlı olduğu tüm yollar üzerinden alır:
\[\delta_j^{(1)} = f'(z_j^{(1)})\sum_k w_{kj}^{(2)}\delta_k^{(2)}\]Böylece gizli katman ağırlığı için sonuç gelir:
\[\frac{\partial L}{\partial w_{ji}^{(1)}}=\delta_j^{(1)}x_i\]Bu ifadeler bir “sihirli formül” değil, zincir kuralının katmanlı hesap grafiğine uygulanmış halidir. Her katman, kendisine gelen hata sinyalini yerel türeviyle çarpar ve bir önceki katmana iletir.
Ağırlık güncellemesi
Gradyan inişi, hatayı artıran değil azaltan yönde yürür:
\[w \leftarrow w-\eta\frac{\partial L}{\partial w}\]Buradaki $\eta$ öğrenme oranıdır. Çok büyükse ağ hedefi ıskalayarak zıplar; çok küçükse öğrenme kahve molasına çıkmış gibi yavaşlar.
# Tek örnek için temel gradyan inişi güncellemesi
delta_out = (y_hat - y) * g_prime(z_out)
grad_w2 = delta_out * a_hidden

# Gizli katmana hata geri taşınır
delta_hidden = (W2.T @ delta_out) * f_prime(z_hidden)
grad_w1 = delta_hidden @ x.T

W2 -= learning_rate * grad_w2
W1 -= learning_rate * grad_w1
Kodda delta_out çıkış hatasını, delta_hidden ise zincir kuralıyla geriye taşınmış hata payını temsil eder. Modern kütüphaneler bu türevleri otomatik hesaplar; ancak arka planda yapılan iş tam olarak budur: tahmin et, hatayı ölç, türevle sorumluluğu dağıt ve ağırlıkları düzelt. Ağın hatalarından ders çıkarması, aslında son derece disiplinli bir matematik muhasebesidir.
Yorumlar