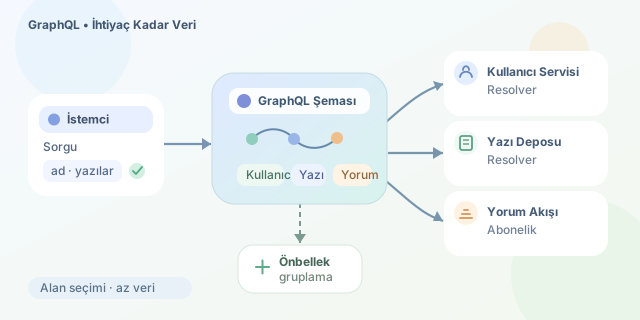
Modern uygulamalarda bir ekranın ihtiyaç duyduğu veri çoğu zaman tek bir kaynaktan gelmez: kullanıcı bilgisi, siparişler, ürün görselleri ve izinler farklı kaynaklara dağılmış olabilir. REST yaklaşımında bu durum genellikle birden fazla endpoint çağrısı veya gereğinden büyük JSON yanıtları anlamına gelir. GraphQL ise istemcinin, sunucuya hangi alanları istediğini açıkça söylediği sorgu tabanlı bir API mimarisidir. Böylece mobil uygulama, web arayüzü ve yönetim paneli aynı veri grafiğini kendi ihtiyaçlarına göre gezebilir.
``
GraphQL’nin temel fikri, API’yi kaynak URL’leri yerine bir şema üzerinden tanımlamaktır. Şema; hangi nesnelerin var olduğunu, alanlarının türlerini ve bu verilere hangi işlemlerle ulaşılacağını belirtir. Örneğin User, Post ve Comment türleri birbirine bağlı bir veri grafiği oluşturur. İstemci bu grafikte istediği dalları tek bir sorguda seçer.
Bir REST yanıtındaki gereksiz alan oranını kabaca şöyle düşünebiliriz:
\[Atik\ Veri\ Orani = 1 - \frac{Istemcinin\ kullandigi\ alanlar}{Sunucunun\ dondugu\ alanlar}\]GraphQL doğru tasarlanmışsa pay ve payda birbirine yaklaşır; yani istemci ihtiyacı olmayan alanları indirmez. Bu, özellikle bağlantı kalitesinin değişken olduğu mobil senaryolarda oldukça değerlidir.
| Konu | REST | GraphQL |
|---|---|---|
| Veri erişimi | Birden fazla endpoint | Genellikle tek endpoint |
| Yanıt şekli | Sunucu belirler | İstemci alan seçer |
| Fazla/eksik veri | Sık görülebilir | Alan seçimiyle azaltılır |
| Sürümleme | /v1, /v2 yaygındır |
Yeni alan ekleme odaklıdır |
| Önbellekleme | HTTP cache için doğaldır | İstemci tarafında ek strateji ister |
Şimdi küçük bir blog şeması düşünelim. Query, okuma işlemlerinin giriş noktasıdır; Mutation ise veri değiştiren işlemler için kullanılır. Aşağıdaki SDL tanımı, API sözleşmesini anlaşılır ve tip güvenli hâle getirir:
type User {
  id: ID!
  name: String!
  email: String!
  posts: [Post!]!
}

type Post {
  id: ID!
  title: String!
  body: String!
  author: User!
}

type Query {
  user(id: ID!): User
}
Bu şema, user sorgusunun zorunlu bir id aldığını ve sonuç olarak bir kullanıcı döndürebileceğini söyler. Ünlem işareti (!) alanın null olamayacağını ifade eder. Ancak user alanının kendisi nullable bırakılmıştır; çünkü istenen kimliğe sahip kullanıcı bulunmayabilir.
İstemci, yalnızca profil kartında kullanılacak alanları şu şekilde ister:
query GetProfile($userId: ID!) {
  user(id: $userId) {
    name
    posts {
      title
    }
  }
}
Burada değişken kullanmak hem sorguyu tekrar kullanılabilir yapar hem de değerleri metne doğrudan gömmeyi önler. Sunucu tarafında ise her alanı veriye bağlayan fonksiyonlara resolver denir. Örneğin Query.user resolver’ı kullanıcıyı veritabanından bulur; User.posts resolver’ı da o kullanıcının yazılarını getirir.
| İşlem türü | Amaç | Örnek |
|---|---|---|
| Query | Veri okumak | Kullanıcı ve yazılarını almak |
| Mutation | Veriyi değiştirmek | Yazı oluşturmak |
| Subscription | Olay akışı dinlemek | Yeni yorum bildirimi almak |
GraphQL sihirli bir performans düğmesi değildir. İç içe sorgular, dikkat edilmezse N+1 sorgu problemine yol açabilir: $1$ kullanıcı sorgusundan sonra her kullanıcı için ayrı yazı sorgusu çalıştırmak maliyetlidir. DataLoader benzeri istek-bazlı önbellekleme araçları, aynı anahtarları gruplayarak bu yükü azaltır. Ayrıca sorgu derinliği, karmaşıklık limiti, yetkilendirme ve alan bazlı hata yönetimi üretim ortamında mutlaka ele alınmalıdır.
Özetle GraphQL, istemci ekiplerine veri şekli üzerinde güçlü bir kontrol verirken sunucu tarafında disiplinli şema ve resolver tasarımı gerektirir. Küçük, sabit ihtiyaçlı servislerde REST hâlâ son derece pratiktir; fakat farklı istemcilerin hızla evrildiği ürünlerde GraphQL, API katmanını çok daha esnek bir konuşma diline dönüştürür.
Yorumlar