İçindekiler
Bir metindeki bütün karakterlere aynı uzunlukta bit dizileri vermek kolaydır; ancak pek ekonomik değildir. Huffman sıkıştırması, sık karşılaşılan karakterlere kısa, nadir karakterlere uzun kodlar atayarak ortalama veri boyutunu azaltır. Böylece algoritma, adeta çok konuşan karakterlere kestirme yol verirken seyrek görünenleri manzaralı ama uzun rotaya gönderir.
``
Temel fikir: Her karakter eşit değildir
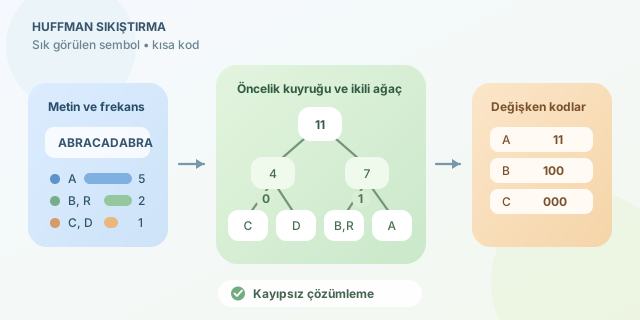
Elimizde ABRACADABRA metni olsun. Bu metinde A beş kez görülürken C yalnızca bir kez görünür. Her karakteri eşit uzunlukta kodlamak yerine A için daha kısa bir kod seçmek toplam bit sayısını düşürür.
Huffman algoritması kayıpsızdır: Sıkıştırılan veri açıldığında orijinal verinin birebir aynısı elde edilir. JPEG gibi bazı yöntemlerin aksine hiçbir karakter gözden çıkarılmaz.
Bir sembolün frekansı $f_i$, ona verilen kodun uzunluğu $l_i$ ise toplam maliyet şöyle ifade edilir:
\[L = \sum_{i=1}^{n} f_i l_i\]Algoritmanın amacı, önek koşulunu koruyarak $L$ değerini küçültmektir. Önek koşulu, hiçbir kodun başka bir kodun başlangıcı olmaması demektir. Örneğin A = 0 iken B = 01 seçilemez; aksi hâlde bitleri okurken nerede duracağımız belirsizleşir.
| Özellik | Sabit uzunluklu kodlama | Huffman kodlama |
|---|---|---|
| Kod uzunluğu | Her sembolde aynı | Frekansa göre değişir |
| Kayıp | Yok | Yok |
| Çözümleme | Doğrudan | Huffman ağacıyla |
| Verimlilik | Dağılımdan etkilenmez | Dengesiz dağılımlarda yüksektir |
| Ek bilgi | Genellikle gerekmez | Kod ağacı veya tablosu gerekir |
Huffman ağacı nasıl kurulur?
Önce her karakterin frekansı hesaplanır ve karakterler bir öncelik kuyruğuna yerleştirilir. Ardından şu döngü uygulanır:
- En düşük frekanslı iki düğümü kuyruktan çıkar.
- Frekansları toplamına eşit yeni bir üst düğüm oluştur.
- İki düğümü bu üst düğümün çocukları yap.
- Yeni düğümü yeniden kuyruğa ekle.
- Tek düğüm kalana kadar işlemi tekrarla.
Ağaç tamamlandığında sol dallara 0, sağ dallara 1 verilebilir. Kökten karaktere kadar izlenen yol, karakterin kodudur. Sol ve sağ seçiminin ters yapılması sıkıştırma oranını değiştirmez; yalnızca ortaya çıkan kodları değiştirir.
Python ile uygulama
Aşağıdaki kod, karakter frekanslarından Huffman ağacı üretir ve her karakterin ikili kodunu çıkarır:
from collections import Counter
import heapq

class Node:
    def __init__(self, char=None, freq=0, left=None, right=None):
        self.char = char
        self.freq = freq
        self.left = left
        self.right = right

    def __lt__(self, other):
        return self.freq < other.freq


def huffman_codes(text):
    heap = [Node(char, freq) for char, freq in Counter(text).items()]
    heapq.heapify(heap)

    if len(heap) == 1:
        return {heap[0].char: "0"}

    while len(heap) > 1:
        left = heapq.heappop(heap)
        right = heapq.heappop(heap)
        parent = Node(freq=left.freq + right.freq,
                      left=left, right=right)
        heapq.heappush(heap, parent)

    codes = {}

    def walk(node, code=""):
        if node.char is not None:
            codes[node.char] = code
            return
        walk(node.left, code + "0")
        walk(node.right, code + "1")

    walk(heap[0])
    return codes

text = "ABRACADABRA"
codes = huffman_codes(text)
encoded = "".join(codes[ch] for ch in text)

print(codes)
print(encoded)
Counter frekansları bulur; heapq ise en küçük iki düğüme verimli biçimde ulaşılmasını sağlar. Tek karakterden oluşan girdiye 0 kodu verilmesi, boş kod gibi kullanışsız bir özel durumu önler. $k$ farklı sembol için ağaç oluşturmanın zaman karmaşıklığı yaklaşık $O(k \log k)$ düzeyindedir.
Her zaman kazandırır mı?
Hayır. Karakterlerin frekansları birbirine çok yakınsa kod uzunlukları da benzer olur. Üstelik çözücünün ağacı öğrenebilmesi için frekans tablosu veya kod sözlüğü dosyaya eklenmelidir. Çok küçük verilerde bu ek yük, elde edilen tasarrufu geçebilir.
Buna rağmen Huffman kodlama; ZIP, DEFLATE, PNG ve çeşitli medya biçimlerinde daha büyük sıkıştırma süreçlerinin önemli bir parçasıdır. Basit fikri, matematiksel sağlamlığı ve ağaç yapılarıyla kurduğu bağ sayesinde hem pratik hem de öğretici bir algoritmadır.
Yorumlar