Bir metindeki aynı karakter dizilerini tekrar tekrar saklamak yerine onlara kısa kodlar verseydik ne olurdu? Lempel–Ziv–Welch, yani LZW algoritması, tam olarak bu fikirle çalışan kayıpsız bir veri sıkıştırma yöntemidir. Metin, görüntü veya benzeri veriler içindeki tekrar eden kalıpları çalışma sırasında oluşturduğu bir sözlükte toplar. Böylece uzun diziler küçük sayılarla temsil edilir; veri hiçbir bilgi kaybedilmeden daha kompakt hâle gelir.
``
LZW’nin temel mantığı
LZW, Terry Welch tarafından LZ78 yaklaşımının geliştirilmesiyle ortaya çıkarılmıştır. Algoritmanın en güzel taraflarından biri, kodlayıcı ile kod çözücünün sözlüğü verinin içine ayrıca eklemesine gerek bırakmamasıdır. Her iki taraf da aynı başlangıç sözlüğünü kullanır ve veriyi işlerken aynı yeni girdileri üretir.
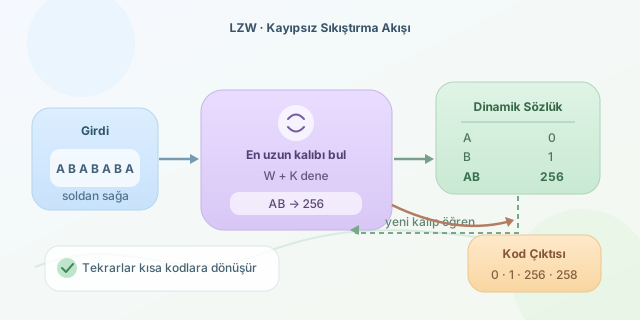
Başlangıç sözlüğünde genellikle kullanılan alfabenin bütün tek karakterleri bulunur. Örneğin ASCII tabanlı bir uygulamada 0–255 arasındaki kodlar hazırdır. Algoritma girdiyi soldan sağa tarar, sözlükte bulunan en uzun diziyi arar ve bu dizinin kodunu çıktıya ekler. Ardından dizinin sonuna gelen yeni karakterle oluşturulan daha uzun kalıbı sözlüğe kaydeder.
Bu davranışı kabaca şöyle ifade edebiliriz:
\[W' = W + K\]Burada $W$, sözlükte bulunan mevcut diziyi; $K$, sıradaki karakteri; $W’$ ise sözlüğe eklenmeye aday yeni kalıbı temsil eder. $W’$ sözlükteyse tarama devam eder. Değilse $W$ kodlanır, $W’$ sözlüğe eklenir ve yeni arama $K$ ile başlar.
| Özellik | LZW | Sabit uzunluklu kodlama |
|---|---|---|
| Tekrarlardan yararlanma | Evet | Hayır |
| Harici sözlük gereksinimi | Yok | Yok |
| Bilgi kaybı | Yok | Yok |
| Değişken kalıpları öğrenme | Dinamik | Bulunmaz |
| Tekrarsız veride verim | Düşebilir | Sabit kalır |
Küçük bir örnek
ABABABA girdisini düşünelim. Başlangıç sözlüğünde A ve B zaten bulunsun. Algoritma önce A kodunu üretir ve AB kalıbını sözlüğe ekler. Sonra B kodlanırken BA eklenir. Tarama ilerlediğinde AB artık tek bir sözlük girdisi olarak tanınır. Daha sonra ABA da öğrenilir. Başlangıçta tek tek görülen karakterler, algoritmanın hafızasında giderek daha büyük parçalara dönüşür.
Sıkıştırma oranı genel olarak şu şekilde hesaplanabilir:
\[R = \frac{\text{Sıkıştırılmış boyut}}{\text{Orijinal boyut}}\]$R < 1$ olması sıkıştırmanın işe yaradığını gösterir. Ancak veri rastgele veya çok kısa ise sözlük kodları ek yük oluşturabileceğinden LZW her zaman kazanç sağlamaz.
Python ile LZW sıkıştırma
Aşağıdaki fonksiyon, başlangıç sözlüğünü 256 karakterle kurar ve keşfettiği kalıplara artan sayısal kodlar verir:
def lzw_compress(text):
    dictionary = {chr(i): i for i in range(256)}
    next_code = 256
    current = ""
    output = []

    for char in text:
        candidate = current + char

        if candidate in dictionary:
            current = candidate
        else:
            output.append(dictionary[current])
            dictionary[candidate] = next_code
            next_code += 1
            current = char

    if current:
        output.append(dictionary[current])

    return output

print(lzw_compress("ABABABA"))
current, sözlükte bulunan en uzun kalıbı tutar. candidate sözlükte yoksa mevcut kalıbın kodu çıktıya gönderilir ve yeni kalıp öğrenilir. Fonksiyonun ürettiği sayılar doğrudan bit düzeyinde paketlenmediği için bu örnek öğretim amaçlıdır. Gerçek sistemlerde kodlar 9, 10 veya 12 bitlik alanlara yerleştirilerek dosya boyutu gerçekten azaltılır.
Nerelerde kullanılır?
LZW özellikle GIF görüntü formatında ve bazı TIFF dosyalarında tanınır. Metinlerdeki, çizimlerdeki ve sınırlı renk paletine sahip görüntülerdeki tekrarlar algoritma için oldukça lezzetli lokmalardır. Buna karşılık modern fotoğraflar veya şifrelenmiş veriler daha düzensiz olduğundan sözlüğün büyümesine rağmen yeterli tekrar sunmayabilir.
Sonuç olarak LZW, veriyi önceden analiz etmeden kalıpları öğrenen zarif bir algoritmadır. Bir bakıma okudukça kelime öğrenen ve uzun cümleleri küçük notlarla hatırlayan dijital bir stenograf gibi davranır.
Yorumlar