İçindekiler
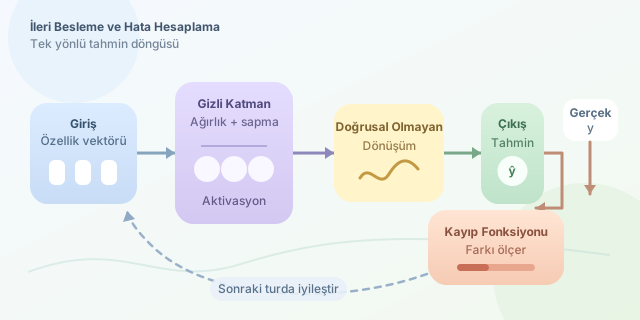
Bir sinir ağını, ham veriyi alıp anlamlı bir tahmine dönüştüren katmanlı bir üretim hattı gibi düşünebiliriz. İleri besleme (feedforward), verinin girişten çıkışa doğru tek yönlü akışıdır; hata hesaplama ise hattın sonunda üretilen sonucun ne kadar başarılı olduğunu söyler. Bu iki adım, eğitimin temel döngüsünü oluşturur: tahmin et, gerçeğe bak, farkı ölç ve sonraki turda daha iyi ol.
``
Girişten Çıkışa Veri Akışı
Bir örnekteki özellikler giriş katmanına vektör olarak verilir. Örneğin bir ev fiyatı modelinde metrekare, oda sayısı ve bina yaşı şu biçimde olabilir: $\mathbf{x} = [120, 3, 8]$. Her nöron, bu girdileri kendi ağırlıklarıyla çarpar, toplar ve bias (sapma) değerini ekler:
\[z = \mathbf{w}^T\mathbf{x} + b\]Buradaki $z$, nöronun henüz ham karar sinyalidir. Ardından aktivasyon fonksiyonu devreye girer ve $a = f(z)$ sonucunu üretir. Aktivasyonlar önemlidir; çünkü ağın doğrusal olmayan, yani karmaşık ilişkileri öğrenebilmesini sağlar. Sadece doğrusal katmanlar kullansaydık, katman sayısı artsa bile model tek bir doğrusal dönüşüme indirgenirdi. Biraz acımasız ama matematik bunu affetmez.
Birden fazla katmanda bu işlem tekrar eder. $l$ katmanındaki hesaplama genel olarak şöyledir:
\(\mathbf{z}^{(l)} = \mathbf{W}^{(l)}\mathbf{a}^{(l-1)} + \mathbf{b}^{(l)}\) \(\mathbf{a}^{(l)} = f^{(l)}(\mathbf{z}^{(l)})\)
İlk katmanda $\mathbf{a}^{(0)} = \mathbf{x}$ kabul edilir. Son katmanın çıktısı ise model tahmini, yani $\hat{y}$ olur.
| Bileşen | Görevi | Kısa benzetme |
|---|---|---|
| Giriş katmanı | Ham özellikleri alır | Malzeme kabul bölümü |
| Gizli katmanlar | Örüntüleri dönüştürür ve temsil eder | Üretim hattı |
| Ağırlıklar | Her girdinin etkisini belirler | Ayarlanabilir düğmeler |
| Aktivasyon | Doğrusal olmayan karar üretir | Filtre veya kapı |
| Çıkış katmanı | Nihai tahmini verir | Kalite raporu |
Tahmin İyi mi? Kayıp Fonksiyonu Karar Verir
İleri besleme tamamlandığında modelin tahmini $\hat{y}$ ile gerçek hedef $y$ karşılaştırılır. Aradaki farkı sayısallaştıran fonksiyona kayıp fonksiyonu (loss function) denir. Kayıp küçükse model daha iyi iş çıkarıyordur; sıfırsa o örnek için kusursuz tahmin yapılmıştır.
Regresyon problemlerinde yaygın tercih Ortalama Kare Hata’dır (MSE):
\[L_{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2\]Kare alma, büyük hataları daha sert cezalandırır. Örneğin 10 birimlik hata, 2 birimlik hatadan yalnızca beş kat değil, $10^2 / 2^2 = 25$ kat daha ağır değerlendirilir. Bu nedenle MSE, aykırı değerlerin çok olduğu veri kümelerinde dikkatle kullanılmalıdır.
| Problem türü | Çıkış aktivasyonu | Yaygın kayıp | Ne ölçer? |
|---|---|---|---|
| Regresyon | Doğrusal | MSE / MAE | Sayısal tahmin farkı |
| İkili sınıflandırma | Sigmoid | Binary Cross-Entropy | İki sınıf olasılığı |
| Çok sınıflı sınıflandırma | Softmax | Categorical Cross-Entropy | Sınıf olasılık dağılımı |
İkili sınıflandırmada sigmoid çıktısı $\hat{y} \in [0,1]$ bir olasılık gibi yorumlanır. Bu durumda Binary Cross-Entropy kullanılır:
\[L_{BCE} = -[y\log(\hat{y}) + (1-y)\log(1-\hat{y})]\]Model gerçek etiket 1 iken 0’a çok yakın güvenle tahmin yaparsa, logaritmik ceza dramatik biçimde büyür. Modelin “eminim” diyerek yanlış cevap vermesi bu yüzden pahalıdır.
Küçük Bir NumPy Örneği
Aşağıdaki kod, tek gizli katmanlı minik bir ağda ileri besleme ve MSE hesabını gösterir. Bu kod eğitim yapmaz; yalnızca ağın mevcut ağırlıklarla ne kadar hata ürettiğini ölçer.
import numpy as np

x = np.array([[0.8, 0.2]])      # Bir örnek, iki özellik
y = np.array([[1.0]])           # Gerçek hedef

W1 = np.array([[0.4, -0.3], [0.1, 0.7]])
b1 = np.array([[0.1, -0.1]])
W2 = np.array([[0.6], [-0.5]])
b2 = np.array([[0.2]])

relu = lambda z: np.maximum(0, z)
sigmoid = lambda z: 1 / (1 + np.exp(-z))

hidden = relu(x @ W1 + b1)
y_hat = sigmoid(hidden @ W2 + b2)
loss = np.mean((y - y_hat) ** 2)

print("Tahmin:", y_hat)
print("MSE kaybı:", loss)
Burada @ matris çarpımını temsil eder. hidden gizli katmanın aktivasyonlarını, y_hat son tahmini taşır. Hesaplanan loss, bir sonraki aşama olan geri yayılımın hangi ağırlıkları ne yönde değiştireceğine rehberlik eder. Kısacası ileri besleme tahmini üretir, kayıp fonksiyonu not verir; geri yayılım ise bu nottan ders çıkarır.
Yorumlar