İçindekiler
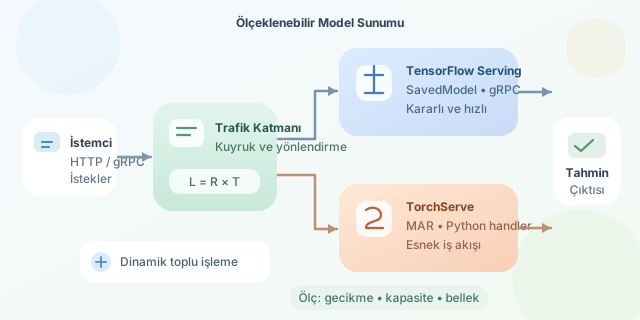
Bir makine öğrenmesi modelini eğitmek, yarışın yalnızca ilk turudur; gerçek ürün yükü başladığında modelin hızlı, güvenilir ve yönetilebilir biçimde tahmin üretmesi gerekir. Model serving araçları bu geçişi düzenler: modeli belleğe alır, HTTP veya gRPC isteklerini karşılar, paralel çağrıları yönetir ve yeni sürümlere kontrollü geçiş sağlar. TensorFlow Serving ile TorchServe, iki büyük ekosistemin bu ihtiyaca verdiği güçlü fakat farklı karakterdeki yanıtlardır.
``
Önce performansın matematiği
Bir servis için en sık konuşulan iki metrik gecikme (latency) ve çıktı kapasitesidir (throughput). Basitçe, saniyedeki istek sayısı $R$ ve ortalama istek süresi $T$ ise, Little Yasası’ndan yararlanarak sistemdeki yaklaşık eşzamanlı iş miktarını şöyle düşünebiliriz:
\[L = R \times T\]Buradaki $L$, kuyrukta veya işlemde bulunan istek sayısıdır. Trafik arttıkça yalnızca CPU/GPU eklemek yetmez; doğru batching, worker sayısı ve model yükleme stratejisi gerekir. Örneğin dinamik batching, kısa bir pencere içinde gelen istekleri tek GPU çağrısında birleştirir. Toplam hesap maliyeti çoğu zaman $n$ ayrı çağrı için $nC$ iken, toplu çağrıda yaklaşık $C_b < nC$ olabilir. Ancak kullanıcıların gördüğü gecikmeye bekleme süresi de eklenir.
| Ölçüt | TensorFlow Serving | TorchServe |
|---|---|---|
| Ana ekosistem | TensorFlow | PyTorch |
| Varsayılan güçlü yön | Yüksek performanslı, kararlı üretim sunumu | Özelleştirilebilir PyTorch dağıtımı |
| API seçenekleri | REST ve özellikle gRPC | REST, gRPC ve yönetim API’leri |
| Model biçimi | SavedModel | MAR veya TorchScript/eager tabanlı paketler |
| Özelleştirme | Daha yapılandırılmış | Python handler’larıyla daha serbest |
TensorFlow Serving: Dar ama hızlı şerit
TensorFlow Serving, C++ tabanlı mimarisi ve TensorFlow SavedModel odaklı yapısıyla tahmin hattını mümkün olduğunca yalın tutar. Model sürümleme, sıcak model yükleme ve gRPC entegrasyonu üretim ekipleri için önemli avantajlardır. Özellikle TensorFlow ile eğitilmiş görüntü, öneri veya tabular modellerde, standart imza (signature) üzerinden tahmin sunmak oldukça doğrudandır.
Aşağıdaki Docker komutu, SavedModel’i models/siniflandirici altında sunar:
docker run -p 8501:8501 \
  -v "$(pwd)/models/siniflandirici:/models/siniflandirici" \
  -e MODEL_NAME=siniflandirici \
  tensorflow/serving
Bu yaklaşımın güzelliği, model kodunu servis sürecine taşımamasıdır: eğitim çıktısı olan SavedModel yeterlidir. Bedeli ise karmaşık ön işleme, özel doğrulama veya çok aşamalı son işleme gerektiğinde esnekliğin sınırlanmasıdır. Bu mantıkları ayrı bir API katmanına koymak sık görülen, temiz bir çözümdür.
TorchServe: Python’ın esnek atölyesi
TorchServe, PyTorch modellerini .mar arşivleriyle paketler. En belirgin farkı, istek ön işleme, tahmin ve çıktı son işleme aşamalarını bir Python handler içinde özelleştirebilmesidir. Metin tokenizasyonu, görüntü dönüşümü veya iş kuralları modelin yanında dağıtılacaksa bu büyük rahatlıktır.
class SinifHandler(BaseHandler):
    def postprocess(self, inference_output):
        skorlar = inference_output[0].softmax(dim=1)
        return [{"sinif": int(skorlar.argmax()),
                 "guven": float(skorlar.max())}]
Bu handler, ham tensör yerine istemcinin doğrudan kullanabileceği sınıf ve güven skoru döndürür. Ne var ki Python tabanlı özelleştirme, yanlış tasarlanırsa darboğaz yaratabilir: ağır tokenizasyon, global durum veya gereksiz veri kopyaları GPU’yu bekleten CPU kuyruklarına dönüşebilir.
| Senaryo | Daha mantıklı tercih | Gerekçe |
|---|---|---|
| Saf TensorFlow SavedModel, düşük gecikme | TensorFlow Serving | Olgun sürümleme ve verimli çalışma zamanı |
| Özel PyTorch ön/son işleme | TorchServe | Handler ile tek pakette iş akışı |
| Çok sayıda standart gRPC çağrısı | TensorFlow Serving | gRPC merkezli, sade mimari |
| Hızlı deney ve Python mantığı | TorchServe | Geliştirici ergonomisi yüksek |
Karar: Benchmark yapmadan bahis oynamayın
Tek bir aracın mutlak kazananı yoktur. Aynı donanımda p50/p95 gecikmesi, saniye başına istek, GPU belleği ve hata oranını ölçün. TensorFlow Serving genellikle standartlaştırılmış TensorFlow dağıtımlarında daha öngörülebilir performans verir. TorchServe ise PyTorch ekibinin karmaşık dönüşümlerini dağıtım sürecine daha az sürtünmeyle dahil eder. En iyi seçim, model formatınız, ekip yetkinliğiniz ve gecikme-esneklik dengenizin ortak sonucudur.
Yorumlar