Bir dizide çok sayıda aralık sorgusu geldiğinde, her sorgu için ilgili elemanları baştan sona gezmek ilk bakışta masum görünür. Ancak $N$ eleman ve $Q$ sorgu için bu yaklaşım $O(NQ)$ maliyet üretir; büyük veri setlerinde bilgisayarınızın fanına mini bir maraton koşturur. Mo’s Algorithm, sorguları çevrimiçi cevaplamak yerine önce toplar, sonra aralık sınırlarının mümkün olduğunca az hareket edeceği bir sıraya koyar. Böylece tekrar eden işi dramatik biçimde azaltır.
``
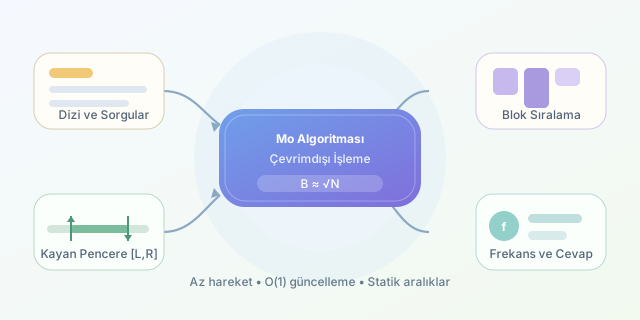
Mo’s Algorithm bir çevrimdışı (offline) algoritmadır: Tüm sorgular cevaplanmadan önce bilinir. Temel fikir kare kök dekompozisyonudur. Dizi indeksleri yaklaşık $B=\sqrt{N}$ uzunluğunda bloklara ayrılır. Sorgular önce sol uçlarının bloğuna, aynı blokta ise sağ uçlarına göre sıralanır. İşlenen mevcut aralık $[L,R]$, bir sonraki sorgunun aralığına taşınırken yalnızca değişen elemanlar veri yapısına eklenir veya çıkarılır.
Örneğin görevimiz her $[l,r]$ aralığındaki farklı sayı adedini bulmak olsun. Mevcut penceredeki her değerin frekansını freq dizisinde tutarız. Bir sayı ilk kez eklenirse distinct artırılır; frekansı sıfıra düşerse azaltılır. Sorgu cevabı böylece anında, yani $O(1)$ sürede okunur.
| Yaklaşım | Sorgu başına maliyet | Toplam maliyet | Ne zaman uygun? |
|---|---|---|---|
| Doğrudan tarama | $O(N)$ | $O(NQ)$ | Çok az sorgu varsa |
| Prefix sum | $O(1)$ | $O(N+Q)$ | Toplam, XOR gibi terslenebilir işlemlerde |
| Segment tree | $O(\log N)$ | $O((N+Q)\log N)$ | Güncelleme varsa |
| Mo’s Algorithm | Amortize hareket maliyeti | Yaklaşık $O((N+Q)\sqrt N)$ | Statik dizi, karmaşık aralık istatistikleri |
Klasik sıralama ile blok boyu genellikle $\sqrt N$ seçilir. Sol sınır bloklar arasında yaklaşık $O(N\sqrt N)$, sağ sınır ise her blokta kontrollü ilerlediği için yine benzer ölçekte hareket eder. Bu nedenle yaygın karmaşıklık ifadesi $O((N+Q)\sqrt N)$ olur. Sabit çarpanlar önemlidir: sağ uç için blok numarasına göre ters yönlü sıralama yapmak, pencerenin gereksiz ileri-geri gezmesini azaltır.
Aşağıdaki C++ örneği, farklı eleman sayısı sorgularını çözer. Değerler büyük olabileceği için önce koordinat sıkıştırma uygulanmıştır; bu, freq dizisini güvenle kullanmamızı sağlar.
struct Query { int l, r, id; };

int block;
bool cmp(const Query& a, const Query& b) {
    int ba = a.l / block, bb = b.l / block;
    if (ba != bb) return ba < bb;
    return (ba & 1) ? a.r > b.r : a.r < b.r;
}

vector<int> moDistinct(vector<int> a, vector<Query> queries) {
    vector<int> vals = a;
    sort(vals.begin(), vals.end());
    vals.erase(unique(vals.begin(), vals.end()), vals.end());
    for (int &x : a)
        x = lower_bound(vals.begin(), vals.end(), x) - vals.begin();

    block = max(1, (int)sqrt(a.size()));
    sort(queries.begin(), queries.end(), cmp);

    vector<int> freq(vals.size()), ans(queries.size());
    int L = 0, R = -1, distinct = 0;
    auto add = [&](int i) { if (freq[a[i]]++ == 0) distinct++; };
    auto remove = [&](int i) { if (--freq[a[i]] == 0) distinct--; };

    for (auto q : queries) {
        while (L > q.l) add(--L);
        while (R < q.r) add(++R);
        while (L < q.l) remove(L++);
        while (R > q.r) remove(R--);
        ans[q.id] = distinct;
    }
    return ans;
}
Burada add ve remove fonksiyonlarının $O(1)$ olması kritik noktadır. Mo’s Algorithm; mod, frekans, en sık görülen değer, çift sayısı veya $\sum_x freq[x]^2$ gibi pencerede ekleme-çıkarma ile güncellenebilen istatistiklerde parlar. Buna karşılık sorgular birbirinin cevabına bağlıysa ya da sık nokta güncellemesi varsa klasik sürümü uygun değildir. Kısacası, sorgular sıraya girmeyi kabul ediyorsa Mo, aralık problemlerinin sakin ama son derece etkili organizatörüdür.
Yorumlar