İçindekiler
Gradient boosting dünyasında doğruluk kadar eğitim süresi ve bellek tüketimi de önemlidir. LightGBM, sürekli özelliklerdeki her değeri ayrı ayrı incelemek yerine değerleri küçük aralıklara, yani bin adı verilen sepetlere yerleştirerek bu dengeyi değiştirdi. Milyonlarca satırlık veriyle çalışan bir algoritma için bu yaklaşım, tek tek bozuk para saymak yerine onları önceden hazırlanmış kutularda tartmaya benzer.
``
Gradient boosting neden pahalıdır?
Gradient boosting, önceki ağaçların hatalarını azaltacak yeni karar ağaçlarını ardışık biçimde üretir. Modelin genel tahmini kabaca şöyle yazılabilir:
\[F_t(x) = F_{t-1}(x) + \eta f_t(x)\]Burada $f_t(x)$ yeni ağacı, $\eta$ ise öğrenme oranını temsil eder. Her düğümde algoritmanın “Bu özelliği hangi değerden bölersem kayıp en fazla azalır?” sorusunu cevaplaması gerekir.
Klasik yaklaşımda sürekli bir özelliğin değerleri sıralanır ve olası eşikler değerlendirilir. $n$ örnek ve $m$ özellik için bu işlem büyük veri kümelerinde ciddi sıralama, tarama ve bellek maliyeti oluşturabilir. Üstelik aynı tür hesaplamalar ağacın birçok düğümünde tekrarlanır.
Histogram numarası
LightGBM, her sürekli özelliği genellikle birkaç yüz bin içine dönüştürür. Örneğin yaş değerleri tek tek tutulmak yerine 18-25, 26-35 ve 36-50 gibi gruplara eşlenebilir. Gerçekte sınırlar veri dağılımına göre daha sistematik belirlenir.
Her bin için gradyan ve Hessian değerleri toplanır:
\[G_b = \sum_{i \in b} g_i, \qquad H_b = \sum_{i \in b} h_i\]Bölünme kazancı artık bütün örnekler yerine bu özetler üzerinden hesaplanabilir. Böylece çalışma maliyeti örnek sayısından çok bin sayısına bağlı hâle gelir. Ayrıca ham ondalıklı değerler yerine küçük tamsayı bin kimlikleri saklanabildiği için bellek kullanımı azalır ve işlemci önbelleği daha verimli kullanılır.
| Yaklaşım | Bölünme adayları | Bellek ihtiyacı | Eğitim davranışı |
|---|---|---|---|
| Geleneksel exact yöntem | Neredeyse tüm benzersiz değerler | Yüksek | Küçük veride hassas, büyük veride pahalı |
| Histogram yöntemi | Sınırlı sayıda bin | Daha düşük | Büyük veride hızlı ve ölçeklenebilir |
| Çok az bin | Çok az eşik | Çok düşük | Hızlı fakat bilgi kaybına açık |
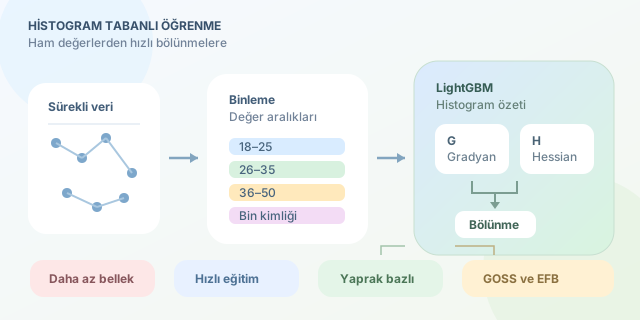
Histogramlar yalnızca hız sağlamaz. Bir düğümün histogramı ile çocuklarından birinin histogramı biliniyorsa diğer çocuk çıkarma işlemiyle bulunabilir. Bu histogram subtraction tekniği, aynı verinin tekrar tekrar taranmasını önler.
LightGBM’i farklılaştıran diğer parçalar
LightGBM’in avantajını yalnızca histogramlara bağlamak eksik olur. Algoritma çoğunlukla ağacı seviye seviye değil, kaybı en fazla azaltan yaprağı büyüterek oluşturur. Leaf-wise büyüme daha düşük kayba hızlı ulaşabilir; ancak küçük verilerde aşırı öğrenme riski taşır. Bu nedenle num_leaves, max_depth ve min_data_in_leaf kritik ayarlardır.
Ayrıca GOSS, gradyanı büyük örnekleri koruyup kolay örneklerden örnekleme yapar. EFB ise aynı anda sıfır olmayan seyrek özellikleri tek özellikte paketleyerek boyutu azaltır.
| Özellik | LightGBM yaklaşımı | Pratik sonuç |
|---|---|---|
| Ağaç büyütme | Leaf-wise | Hızlı kayıp azalması, daha yüksek overfitting riski |
| Örnek seçimi | GOSS | Daha az örnekle önemli hataları koruma |
| Seyrek özellikler | EFB | Daha az özellik taraması |
| Değer işleme | Histogram binleri | Daha düşük bellek ve daha hızlı eğitim |
Python ile küçük bir deney
Aşağıdaki kod, histogram çözünürlüğünü belirleyen max_bin seçeneğiyle bir sınıflandırıcı kurar:
from lightgbm import LGBMClassifier
from sklearn.metrics import accuracy_score

model = LGBMClassifier(
    n_estimators=400,
    learning_rate=0.05,
    num_leaves=31,
    max_bin=255,
    min_child_samples=30,
    random_state=42
)

model.fit(X_train, y_train)
predictions = model.predict(X_test)
print(accuracy_score(y_test, predictions))
max_bin artırılırsa daha hassas eşikler elde edilebilir; fakat eğitim ve bellek maliyeti yükselir. Azaltılırsa model hızlanır, ancak önemli ayrımlar aynı sepete düşebilir.
Sonuç olarak LightGBM, özellikle büyük ve yüksek boyutlu verilerde XGBoost’un tarihsel exact yaklaşımını hız ve bellek bakımından geçebildi. Güncel XGBoost sürümlerinin de histogram tabanlı yöntemler sunduğunu unutmamak gerekir; dolayısıyla mutlak bir şampiyon yoktur. Asıl sır, daha fazla hesaplamak değil, veriyi akıllıca özetleyerek doğru hesapları yapmaktır.
Yorumlar