İçindekiler
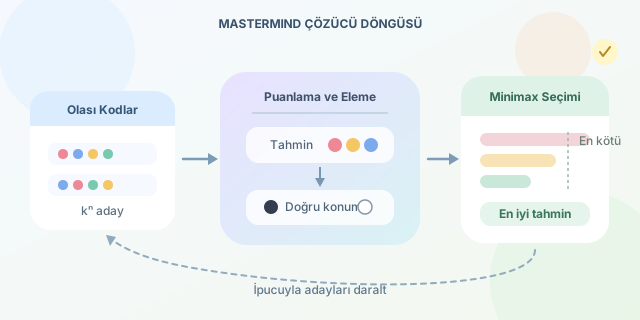
Mastermind, birkaç renkli pimin masum görünümü altında ciddi bir arama problemi saklar. Oyuncunun amacı, sınırlı sayıdaki tahminle gizli kodu bulmaktır. Her tahminden sonra alınan “doğru renk ve doğru konum” ile “doğru renk, yanlış konum” ipuçları, olası kodları adım adım elemeyi sağlar. Gelin bu mantığı bilgisayara öğretelim ve şansa güvenmek yerine sistematik düşünen bir çözücü geliştirelim. ``
Problemi matematiksel olarak tanımlayalım
Kod uzunluğu $n$, kullanılabilecek renk sayısı ise $k$ olsun. Renk tekrarına izin verildiğinde toplam olası kod sayısı:
\[N = k^n\]Örneğin klasik bir oyunda $n=4$ ve $k=6$ ise:
\[N = 6^4 = 1296\]Bu sayı bilgisayar için oldukça küçüktür. Dolayısıyla bütün kodları üretip her ipucundan sonra uyumsuz olanları silmek mümkündür. Algoritmanın temel fikri şöyledir:
- Bütün olası kodları oluştur.
- Bir tahmin seç.
- Tahmine verilen geri bildirimi al.
- Aynı geri bildirimi üretmeyecek adayları ele.
- Tek aday kalana veya kod bulunana kadar tekrarla.
Geri bildirim nasıl hesaplanır?
Mastermind değerlendirmesinde iki değer bulunur:
| İpucu | Anlamı | Örnek |
|---|---|---|
| Siyah pim | Renk ve konum doğru | Gizli 1234, tahmin 1536: 1 doğru |
| Beyaz pim | Renk doğru, konum yanlış | Gizli 1234, tahmin 2416: 2 ve 4 yanlış yerde |
| Boş | Renk kodda yok | Gizli 1234, tahmindeki 6 |
Önce tam eşleşmeleri saymak önemlidir. Ardından bu konumlar değerlendirme dışı bırakılarak kalan renklerin ortak miktarı hesaplanır. Aksi hâlde tekrarlanan renkler iki kez sayılabilir; algoritmik muz kabuğu tam olarak burada duruyor!
from collections import Counter
from itertools import product

def puanla(gizli, tahmin):
    tam = sum(a == b for a, b in zip(gizli, tahmin))

    kalan_gizli = [a for a, b in zip(gizli, tahmin) if a != b]
    kalan_tahmin = [b for a, b in zip(gizli, tahmin) if a != b]

    cg = Counter(kalan_gizli)
    ct = Counter(kalan_tahmin)
    yanlis_yer = sum((cg & ct).values())
    return tam, yanlis_yer
Bu fonksiyon, iki kod arasındaki ilişkiyi (tam, yanlış_yer) biçiminde döndürür. Counter kesişimi, her rengin yalnızca iki tarafta bulunan en küçük adedi kadar sayılmasını sağlar.
Adayları filtreleyen çözücü
Her turda yalnızca alınan ipucuyla uyumlu kodları tutabiliriz:
def tum_kodlar(renkler, uzunluk):
    return list(product(renkler, repeat=uzunluk))

def adaylari_filtrele(adaylar, tahmin, cevap):
    return [kod for kod in adaylar if puanla(kod, tahmin) == cevap]

renkler = range(6)
adaylar = tum_kodlar(renkler, 4)

tahmin = (0, 0, 1, 1)
cevap = (1, 1)  # Oyundan veya kullanıcıdan alınır
adaylar = adaylari_filtrele(adaylar, tahmin, cevap)

print("Kalan aday:", len(adaylar))
Filtreleme neden doğrudur? Gerçek gizli kod, yapılan tahmin karşısında verilen cevabı üretmek zorundadır. Bir aday farklı puan üretiyorsa onun gizli kod olması mantıksal olarak imkânsızdır.
Tahmin seçme stratejileri
| Strateji | Avantaj | Dezavantaj |
|---|---|---|
| İlk adayı seç | Çok kolay ve hızlı | Gereksiz fazla tur sürebilir |
| Rastgele aday | Basit ve eğlenceli | Başarı kararlı değildir |
| En çok renk çeşitliliği | Başlangıçta bilgi toplar | Her durumda en iyi değildir |
| Minimax | En kötü durumu küçültür | Daha fazla hesaplama ister |
Minimax yaklaşımı, her olası tahminin adayları hangi cevap gruplarına böleceğini inceler. En büyük grubun boyutu $G(t)$ olsun. Seçilecek tahmin:
\[t^* = \arg\min_t G(t)\]Böylece algoritma, rakibin verebileceği en az yardımcı cevapta bile mümkün olduğunca az aday bırakmaya çalışır. Bu, “Umarım şansım yaver gider” yerine “En kötü ihtimale hazırım” demektir.
def minimax_tahmin(adaylar):
    en_iyi, en_kotu_boyut = None, float("inf")

    for tahmin in adaylar:
        gruplar = {}
        for gizli in adaylar:
            sonuc = puanla(gizli, tahmin)
            gruplar[sonuc] = gruplar.get(sonuc, 0) + 1

        en_buyuk_grup = max(gruplar.values())
        if en_buyuk_grup < en_kotu_boyut:
            en_iyi = tahmin
            en_kotu_boyut = en_buyuk_grup

    return en_iyi
Bu sürüm öğretici ve orta ölçekli oyunlar için yeterlidir. Daha büyük problemlerde önbellekleme, örnekleme veya bilgi entropisi kullanılabilir. Entropi yaklaşımı, beklenen bilgi kazancını yükseltmeye çalışır:
\[H = -\sum_i p_i \log_2 p_i\]Sonuç olarak Mastermind çözücüsü; kombinatorik arama, kısıt yayılımı ve karar teorisini tek projede buluşturur. Aynı yaklaşım parola benzeri bulmacalara, test optimizasyonuna ve hata teşhisine de uyarlanabilir. Renkli pimlerle başlayan macera, küçük ama oldukça şık bir yapay zekâ uygulamasına dönüşür.
Yorumlar