İçindekiler
Bir makine öğrenmesi modeli, eline verilen sütunların arkasındaki gerçek dünyayı kendiliğinden anlayamaz. Bir müşterinin doğum tarihinden yaşını, işlem zamanından alışveriş alışkanlığını veya metindeki kelimelerden duyguyu çıkarmak çoğu zaman bizim görevimizdir. Özellik mühendisliği, ham veriyi modelin daha kolay öğrenebileceği anlamlı değişkenlere dönüştürme sanatıdır. Bazen doğru tasarlanmış tek bir özellik, daha karmaşık bir model seçmekten çok daha büyük fark yaratır.
``
Özellik neden bu kadar önemlidir?
Bir modelin başarısı kabaca veri kalitesi, model kapasitesi ve hedefle ilişkili sinyalin gücüne bağlıdır. Özellikler, bu sinyali görünür hâle getirir. Örneğin ev fiyatı tahmininde metrekare yararlıdır; ancak oda_sayisi / metrekare oranı evin kullanım yoğunluğu hakkında ek bilgi sunabilir. Benzer şekilde yalnızca satış tutarını değil, müşterinin son 30 gündeki toplam harcamasını bilmek de davranış desenini yakalayabilir.
Lineer bir model için temel ilişki şöyle yazılabilir:
\[\hat{y} = w_0 + w_1x_1 + w_2x_2 + \dots + w_nx_n\]Burada model, özellikler ile hedef arasındaki ilişkiyi ağırlıklar üzerinden öğrenir. İlişki ham sütunlarda gizliyse modelin işi zorlaşır. Dönüşümler sayesinde ilişki daha doğrusal, daha ayırt edici veya daha kararlı hâle gelebilir.
| Ham veri | Türetilmiş özellik | Sağladığı anlam |
|---|---|---|
dogum_tarihi |
yas |
Yaşam evresi ve satın alma gücü |
islem_tarihi |
hafta_sonu_mu |
Zaman bazlı davranış farkı |
gelir, borc |
borc_gelir_orani |
Finansal risk seviyesi |
| Ürün açıklaması | Kelime sayısı, TF-IDF | Metinsel içerik sinyali |
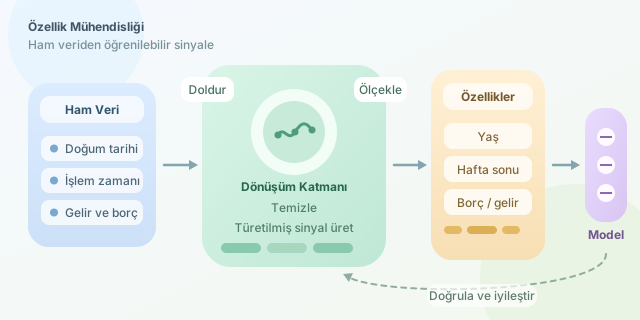
Yaygın dönüşüm teknikleri
Sayısal verilerde eksik değer doldurma, aykırı değer yönetimi, logaritmik dönüşüm ve ölçekleme sık kullanılır. Özellikle gelir veya işlem tutarı gibi sağa çarpık dağılımlarda $x’ = \log(1+x)$ dönüşümü büyük değerlerin etkisini dengeler. Standartlaştırma ise değişkenleri ortak bir ölçeğe taşır:
\[z = \frac{x - \mu}{\sigma}\]Kategorik değişkenler için en temel yöntem one-hot encoding’dir. Ancak binlerce farklı şehir, ürün veya kullanıcı kimliği varsa ortaya çok geniş bir matris çıkar. Bu durumda frekans kodlama, hedef kodlama veya embedding gibi alternatifler değerlendirilebilir. Hedef kodlama yapılırken veri sızıntısına dikkat edilmelidir: Bir satırın hedef bilgisi, o satıra ait özelliği üretirken kullanılmamalıdır.
| Teknik | Ne zaman tercih edilir? | Dikkat edilmesi gereken |
|---|---|---|
| One-hot encoding | Az kategorili alanlar | Boyut patlaması |
| Log dönüşümü | Çarpık pozitif sayılar | Negatif değerler |
| Ölçekleme | KNN, SVM, lojistik regresyon | Eğitim verisine göre fit etmek |
| Tarih parçalama | Zaman damgalı kayıtlar | Geleceğe dair bilgi sızıntısı |
Küçük ama etkili bir Python örneği
Aşağıdaki örnek, müşteri verisinden yaş, hafta sonu bilgisi ve borç/gelir oranı üretir. Ayrıca eksik gelirleri medyanla doldurur.
import pandas as pd

veri = pd.DataFrame({
    "dogum_tarihi": ["1990-05-12", "1982-11-03"],
    "islem_tarihi": ["2026-07-18", "2026-07-20"],
    "gelir": [55000, None],
    "borc": [12000, 18000]
})

veri["dogum_tarihi"] = pd.to_datetime(veri["dogum_tarihi"])
veri["islem_tarihi"] = pd.to_datetime(veri["islem_tarihi"])

bugun = pd.Timestamp("2026-07-31")
veri["yas"] = ((bugun - veri["dogum_tarihi"]).dt.days / 365.25).astype(int)
veri["hafta_sonu_mu"] = (veri["islem_tarihi"].dt.dayofweek >= 5).astype(int)
veri["gelir"] = veri["gelir"].fillna(veri["gelir"].median())
veri["borc_gelir_orani"] = veri["borc"] / veri["gelir"]
Özellik mühendisliği bir kerelik sihirli değnek değildir; hipotez kurma, deneme ve doğrulama döngüsüdür. Özellikleri yalnızca eğitim verisinde tasarlayıp dönüşüm parametrelerini orada öğrenin; sonra aynı işlemi doğrulama ve test verisine uygulayın. Başarılı bir modelin sırrı çoğu zaman daha fazla sütunda değil, problemi gerçekten anlatan doğru sütunlardadır.
Yorumlar