İçindekiler
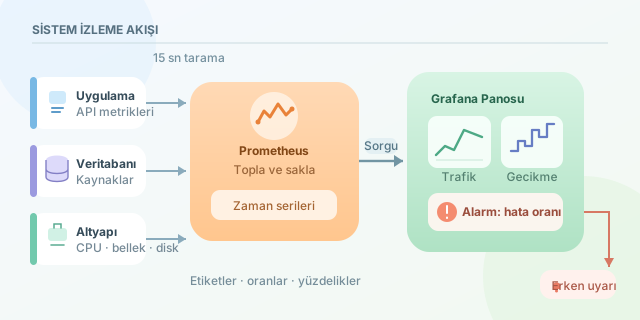
Bir uygulamanın çalışıyor olması, sağlıklı çalıştığı anlamına gelmez. Kullanıcılar yavaşlama hissetmeden, disk dolmadan veya hata oranı büyümeden önce sinyal almak için gözlemlenebilirliğe ihtiyaç duyarız. Prometheus metrikleri toplayan zaman serisi veritabanı ve sorgu motorudur; Grafana ise bu sayıları anlaşılır grafiklere, alarmlara ve panolara dönüştürür. İkili birlikte çalıştığında sunucudan API’ye, veritabanından iş kuyruğuna kadar sistemin nabzını izlemeyi mümkün kılar.
``
Zaman serisi verisi neden farklıdır?
Klasik veritabanları genellikle “bu kullanıcının e-postası nedir?” gibi anlık durum sorularını yanıtlar. Zaman serisi verisi ise bir ölçümün zaman boyunca nasıl değiştiğiyle ilgilenir. Prometheus’ta her örnek kabaca şu yapıdadır:
\[m(t) = (\text{metric\_name}, \text{labels}, \text{value}, \text{timestamp})\]Örneğin http_requests_total{method="GET",status="200"} sayacı, başarılı GET isteklerinin zamanla artan toplamını tutar. Etiketler (labels) aynı metriği servis, ortam veya HTTP durum koduna göre filtrelemeyi sağlar. Ancak etiketlere kullanıcı kimliği ya da rastgele istek UUID’si koymak kötü fikirdir: her benzersiz etiket yeni bir seri üretir. Buna yüksek kardinalite denir ve Prometheus’un belleğini hızla tüketebilir.
| Kavram | Ne tutar? | Tipik örnek |
|---|---|---|
| Counter | Yalnızca artan toplam | Toplam HTTP isteği |
| Gauge | Anlık, artıp azalabilen değer | Aktif bağlantı sayısı |
| Histogram | Değer dağılımı ve gecikme kovaları | İstek süresi |
| Summary | Uygulama tarafında hesaplanan özet | Belirli yüzdelikler |
Prometheus: pull modelinin gücü
Prometheus genellikle metrikleri uygulamaya “itmek” yerine belirli aralıklarla endpoint’lerden çeker. Uygulamanız /metrics adresinde ölçümleri yayınlar; Prometheus da yapılandırılmış hedef listesine göre bunları tarar. Bu yaklaşım, hedefin erişilebilirliğini de doğal olarak doğrular.
Aşağıdaki temel yapılandırma, bir Node.js API’sini 15 saniyede bir toplar:
scrape_configs:
  - job_name: "api"
    scrape_interval: 15s
    static_configs:
      - targets: ["api:3000"]
Altyapı metrikleri için çoğunlukla node_exporter, konteyner dünyası için cAdvisor, veritabanları içinse ilgili exporter kullanılır. Böylece CPU, bellek, disk alanı ve ağ verileri uygulama metrikleriyle aynı sorgu dilinde birleşir.
PromQL tarafında en önemli ayrım, toplam sayaç ile hız değeridir. Saniye başına istek oranını görmek için ham sayacı değil rate fonksiyonunu kullanırız:
sum(rate(http_requests_total{job="api"}[5m])) by (status)
Bu sorgu son beş dakikalık pencereye göre her HTTP durum kodunun istek/saniye oranını hesaplar. Hata oranı da şu mantıkla bulunabilir:
\[\text{Hata Oranı} = \frac{\text{5xx istek hızı}}{\text{Tüm istek hızı}} \times 100\]100 * sum(rate(http_requests_total{status=~"5.."}[5m]))
/ sum(rate(http_requests_total[5m]))
Grafana: sayıları hikâyeye dönüştürmek
Grafana’da Prometheus veri kaynağını ekledikten sonra her panel bir PromQL sorgusuna bağlanır. İyi bir pano, mümkün olan her metriği sergilemez; operasyonel sorulara cevap verir: “Sistem kullanılabilir mi?”, “Yavaş mı?”, “Hata üretiyor mu?”, “Kaynak sınırına yaklaştı mı?”
| Panel | Sorgu yaklaşımı | Yorum |
|---|---|---|
| Trafik | sum(rate(...[5m])) |
İstek yoğunluğunu gösterir |
| Gecikme | histogram_quantile(0.95, ...) |
P95 kullanıcı deneyimini izler |
| Hata oranı | 5xx / tüm istekler | Sürüm sorunlarını yakalar |
| Disk kullanımı | Boş alan veya doluluk yüzdesi | Kapasite alarmı üretir |
Özellikle ortalama gecikme yanıltıcı olabilir. On kullanıcıdan dokuzu 50 ms, biri 5 saniye beklerse ortalama yaklaşık 545 ms olur; oysa sorun yaşayan kullanıcı için gerçek deneyim çok daha kötüdür. Bu nedenle P95 veya P99 yüzdelikleri daha değerlidir.
Son adım alarm kurmaktır. Örneğin hata oranı 10 dakika boyunca %2’nin üzerindeyse alarm üretmek mantıklıdır. Alarm eşiğini körü körüne seçmek yerine normal davranış çizgisini önce Grafana’da inceleyin. Böylece gecenin üçünde gelen her bildirim gerçekten aksiyon gerektirir; izleme sistemi de gürültü makinesi değil, güvenilir bir erken uyarı radarı olur.
Yorumlar