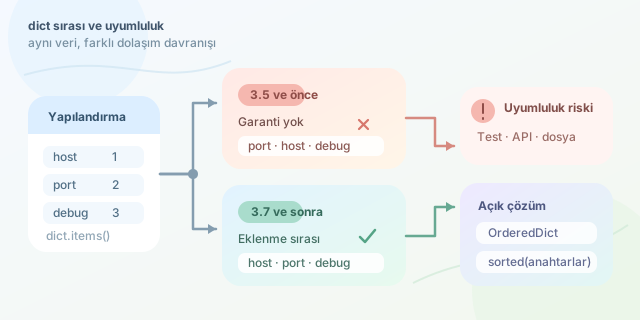
Python sözlükleri bugün anahtarları eklenme sırasına göre dolaştığı için oldukça öngörülebilir davranıyor. Ancak eski bir Python sürümünde çalışan projeyi ayağa kaldırdığınızda aynı kodun farklı sırada çıktı üretmesi mümkündür. Bu durum yalnızca estetik bir farklılık değildir; testleri, dosya üretimini, API yanıtlarını ve hatta uygulama mantığını bozabilen sinsi bir uyumluluk problemidir. ``
“Sırasız” tam olarak ne demekti?
Bir dict, anahtarları değerlere bağlayan hash tablosu tabanlı bir veri yapısıdır. Bir anahtarın yerleşimi kabaca şu ilişkiyle düşünülebilir:
Buradaki $N$, tablonun kapasitesini temsil eder. Python 3.7 öncesinde sözlüğün dolaşım sırası, anahtarların eklenme zamanından ziyade hash değerleri, tablonun boyutu ve yeniden boyutlandırma işlemleri gibi ayrıntılardan etkilenebilirdi.
“Sırasız” ifadesi, öğelerin her erişimde mutlaka rastgele dizildiği anlamına gelmez. Asıl anlamı, programcının gözlemlediği sıranın dil tarafından garanti edilmemesidir. Aynı makinede kararlı görünen bir çıktı, başka Python sürümünde veya farklı bir süreçte değişebilirdi. Hash randomization özelliği de özellikle metin anahtarlarında süreçler arasında farklılık oluşturabilir.
| Sürüm | dict sırası |
Güvenilebilir mi? |
|---|---|---|
| Python 3.5 ve öncesi | Belirli olmayan sıra | Hayır |
| CPython 3.6 | Eklenme sırası pratikte korunur | Dil garantisi değildir |
| Python 3.7 ve sonrası | Eklenme sırası korunur | Evet |
Eski sürümlerde OrderedDict |
Eklenme sırası korunur | Evet |
CPython 3.6’da sıralı davranış, daha kompakt sözlük uygulamasının bir sonucu olarak ortaya çıktı. Python 3.7 ile bu davranış resmi dil özelliği hâline geldi.
Eski kod nasıl bozulur?
Aşağıdaki kod modern Python’da host, port, debug sırasını korur:
config = {}
config["host"] = "localhost"
config["port"] = 8000
config["debug"] = True

line = ";".join(f"{key}={value}" for key, value in config.items())
print(line)
Kod, yapılandırmayı tek satırlık bir metne dönüştürür. Python 3.7 ve sonrasında sonuç öngörülebilirken eski sürümlerde alanlar farklı sırada gelebilir. Bu metin bir snapshot testiyle karşılaştırılıyorsa test başarısız olur. Daha kötüsü, sıralamaya duyarlı eski bir tüketici varsa veri yanlış yorumlanabilir.
Benzer riskler şuralarda görülür:
- JSON veya CSV benzeri çıktıların metinsel olarak karşılaştırılması,
- HTML şablonlarında alanların beklenen sırada gösterilmesi,
- Komut satırı argümanlarının sözlükten üretilmesi,
- Sözlük anahtarlarının indeks gibi kullanılması,
- Snapshot ve golden file testleri.
Teorik olarak bir eşlemenin doğruluğu sıra üzerinden değil, anahtar-değer çiftleri üzerinden tanımlanmalıdır:
\[D_1 = D_2 \iff \forall k,\ D_1[k] = D_2[k]\]Yani iki sözlük aynı çiftlere sahipse dolaşım sıraları farklı olsa bile eşit kabul edilir.
Güvenli uyumluluk yöntemleri
Sıra iş mantığının parçasıysa eski sürümlerde OrderedDict kullanılmalıdır:
from collections import OrderedDict

config = OrderedDict([
    ("host", "localhost"),
    ("port", 8000),
    ("debug", True),
])

for key, value in config.items():
    print(key, value)
Amaç yalnızca deterministik çıktıysa anahtarları açıkça sıralamak daha net olabilir:
for key in sorted(config):
    print(f"{key}={config[key]}")
| İhtiyaç | Tercih |
|---|---|
| Eklenme sırasını korumak | OrderedDict veya Python 3.7+ |
| Alfabetik çıktı üretmek | sorted(dict) |
| Yalnızca içerik karşılaştırmak | Doğrudan sözlük eşitliği |
| Çok sürümlü kütüphane geliştirmek | Desteklenen en eski sürümde test |
Sonuç olarak modern dict davranışını geçmişe doğru varsaymak tehlikelidir. Legacy kod incelerken items(), keys() ve sözlük üzerinde doğrudan dönen her döngüye dikkat etmek gerekir. Sıra önemliyse bunu açıkça ifade etmek, Python’un tarihsel davranışlarına güvenmekten çok daha sağlamdır.
Yorumlar