İçindekiler
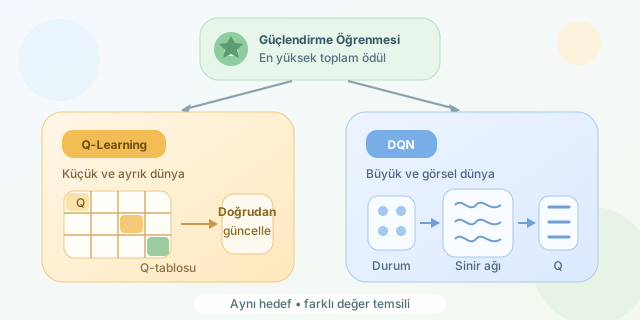
Güçlendirme öğrenmesinde (Reinforcement Learning, RL) bir ajanın amacı, deneme-yanılma yoluyla en yüksek toplam ödülü getiren davranışı öğrenmektir. Q-learning ve Derin Q-Network (DQN), bu hedefe ulaşmak için kullanılan iki popüler yöntemdir; ancak biri küçük dünyaların tablo ustasıyken, diğeri yüksek boyutlu problemlerde sahneye çıkan derin öğrenme oyuncusudur.
``
Bir RL problemi genellikle durum $s$, eylem $a$, ödül $r$ ve bir sonraki durum $s’$ bileşenleriyle tanımlanır. Ajandaki temel soru şudur: “Bu durumda bu eylemi seçersem, gelecekte ne kadar ödül beklemeliyim?” Bu beklentiyi temsil eden fonksiyon, eylem-değer fonksiyonu ya da $Q$ fonksiyonudur:
\[Q(s, a) = \mathbb{E}\left[\sum_{t=0}^{\infty} \gamma^t r_t\right]\]Burada $\gamma$ indirim katsayısıdır. Değeri 0’a yakınsa ajan kısa vadeli ödüllere, 1’e yakınsa uzun vadeli sonuçlara daha çok önem verir.
Q-Learning: Tabloyu Dolduran Klasik Yaklaşım
Klasik Q-learning, her durum-eylem çifti için bir değer saklayan Q-tablosu kullanır. Güncelleme kuralı Bellman denkleminin pratik hâlidir:
\[Q(s,a) \leftarrow Q(s,a) + \alpha[r + \gamma \max_{a'}Q(s',a') - Q(s,a)]\]$\alpha$ öğrenme oranıdır. Ajan önce mevcut tahminini görür, ardından aldığı ödül ve sonraki durumun en iyi tahminine göre bu değeri düzeltir. GridWorld gibi 16 veya 100 hücreli küçük ortamlarda yöntem son derece anlaşılır ve hızlıdır. Fakat durum uzayı büyüdüğünde tablo da kontrolden çıkar: Bir görüntüdeki milyonlarca olası piksel kombinasyonunu tabloya yazmaya kalkmak, dijital bir ansiklopediyle okyanusu taşımaya benzer.
DQN: Tablo Yerine Sinir Ağı
DQN, $Q(s,a)$ değerini doğrudan bir tabloyla saklamak yerine bir sinir ağıyla yaklaşıklar. Ağ, durumları girdi olarak alır ve her olası eylem için Q değerleri üretir. Örneğin Atari oyununda giriş ekran görüntüleri, çıkış ise “sola git”, “sağa git” veya “ateş et” gibi eylemlerin değerleri olabilir.
DQN’in kararlı öğrenmesini sağlayan iki önemli fikri vardır: experience replay ve target network. Replay belleği, ajanın geçmiş deneyimlerini $(s,a,r,s’)$ şeklinde saklar ve rastgele örnekler. Böylece birbirine çok benzeyen ardışık deneyimlerin eğitimi bozması azaltılır. Target network ise hedef Q değerlerini daha yavaş güncellenen ayrı bir ağla hesaplayarak hedefin sürekli kaçmasını önler.
| Özellik | Q-Learning | DQN |
|---|---|---|
| Değer temsili | Açık Q-tablosu | Sinir ağı yaklaşımı |
| Uygun ortam | Küçük, ayrık durum uzayı | Büyük veya sürekli görsel girdiler |
| Veri ihtiyacı | Genellikle düşüktür | Genellikle daha yüksektir |
| Yakınsama davranışı | Koşullar sağlanırsa teorik garanti güçlüdür | Kararlılık, mimari ve hiperparametrelere bağlıdır |
| Hesaplama maliyeti | Çok düşüktür | GPU ve eğitim süresi gerektirebilir |
Basit Bir GridWorld Deneyi
4x4 GridWorld ortamında ajan başlangıçtan hedefe ulaşsın; her adımda $-1$, hedefte $+10$ ödül alsın. Aynı ortamda iki yöntemi bölüm başına toplam ödül üzerinden karşılaştırabilirsiniz. Q-learning için durumları hücre indeksleriyle temsil etmek yeterlidir. DQN’de ise bu indeksler one-hot vektöre dönüştürülerek ağa verilebilir.
# Q-learning güncellemesinin özeti
q[state, action] += alpha * (
    reward + gamma * q[next_state].max() - q[state, action]
)

# DQN hedef değeri: ağ, tablo yerine Q değerlerini tahmin eder
with torch.no_grad():
    target = reward + gamma * target_net(next_state).max(dim=1).values
loss = torch.nn.functional.mse_loss(policy_net(state)[action], target)
Bu kodda ilk satır tablo hücresini doğrudan günceller. İkinci yaklaşımda ise hata ($loss$) geriye yayılım ile sinir ağının ağırlıklarını değiştirir. Küçük GridWorld’de Q-learning çoğu zaman daha az bölümde ve daha tutarlı biçimde iyi politikaya ulaşır. Çünkü öğrenilecek parametre sayısı azdır ve fonksiyon yaklaşım hatası yoktur.
DQN ise bu küçük ortamda gereksiz derecede ağır kalabilir; başlangıçta daha yavaş yakınsar ve ödül eğrisi daha dalgalı görünür. Buna rağmen ortamı görüntü tabanlı hâle getirir, durum sayısını büyütür veya sürekli özellikler eklerseniz Q-tablosu hızla pratikliğini kaybeder. İşte bu noktada DQN genelleme yeteneği sayesinde avantaj kazanır. Kısacası: küçük dünyada Q-learning bir cep bıçağıdır; büyük ve karmaşık dünyada DQN tam bir alet çantasıdır.
Yorumlar