İçindekiler
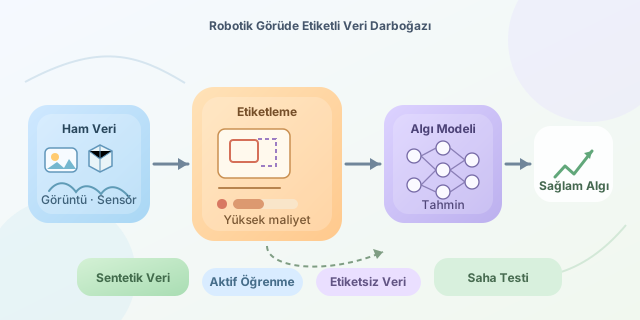
Bir robotun masadaki bardağı tanıması bize son derece doğal görünebilir. Ancak robot için görüntü, anlamlı nesnelerden değil, sayısal piksel dizilerinden oluşur. Denetimli öğrenme bu sayılara anlam kazandırabilir; fakat bunun için binlerce, hatta milyonlarca doğru etiketlenmiş örnek gerekir. Robotik dünyasında bu gereksinim, algılama modellerinin önündeki en pahalı ve en inatçı engellerden biridir. ``
Denetimli öğrenmenin temel mantığı
Denetimli öğrenmede model, giriş ve doğru çıktı çiftlerinden oluşan bir veri kümesiyle eğitilir. Bir kamera görüntüsü $x$, görüntüdeki nesnenin etiketi ise $y$ olsun. Modelin amacı, görüntüyü etikete dönüştüren yaklaşık bir $f_\theta$ fonksiyonu öğrenmektir:
\[\hat{y} = f_\theta(x)\]Buradaki $\theta$, sinir ağının eğitim sırasında ayarlanan parametrelerini temsil eder. Model tahmini ile gerçek etiket arasındaki fark bir kayıp fonksiyonuyla ölçülür:
\[\theta^* = \arg\min_\theta \frac{1}{N}\sum_{i=1}^{N} L(f_\theta(x_i), y_i)\]Kısacası model, yaptığı hataları azaltarak öğrenir. Fakat doğru cevapları gösteren $y_i$ etiketleri azsa, hatalıysa veya gerçek çalışma ortamını temsil etmiyorsa robot sağlam bir algı geliştiremez.
Robotikte etiket neden pahalıdır?
İnternetteki kedi fotoğraflarını sınıflandırmak görece kolaydır. Robotik verilerde ise yalnızca “bu bir kutudur” demek yetmeyebilir. Kutunun piksel düzeyindeki sınırı, üç boyutlu konumu, yönelimi, uzaklığı ve tutulabilir bölgeleri de işaretlenebilir. LiDAR nokta bulutları, termal kameralar ve kuvvet sensörleri gibi farklı kaynaklar işi daha da zorlaştırır.
| Veri türü | Gerekli etiket | Başlıca zorluk |
|---|---|---|
| RGB görüntü | Sınıf veya kutu | Örtüşme ve ışık değişimi |
| Segmentasyon | Her pikselin sınıfı | Çok yüksek işçilik |
| Nokta bulutu | 3B kutu ve konum | Uzman araç gereksinimi |
| Robot kavrama | Başarı, poz ve temas | Fiziksel deneme maliyeti |
Üstelik fabrikada toplanan veriler, açık havada çalışan bir robotu temsil etmeyebilir. Bu durum dağılım kayması olarak adlandırılır. Eğitim verisi $P_{train}(x)$ ile gerçek ortam $P_{real}(x)$ farklı olduğunda yüksek laboratuvar başarısı sahada hızla düşebilir.
Az etiketin model üzerindeki etkileri
Etiketli veri eksikliği yalnızca doğruluğu azaltmaz. Nadir nesneler yeterince görülmediği için sınıf dengesizliği oluşur. Model arka plan, renk veya ışık gibi yanıltıcı ipuçlarını ezberleyebilir. Yeni bir kamera açısı karşısında şaşırabilir ve belirsiz olduğu durumlarda bile aşırı güvenli tahminler üretebilir. Otonom araç veya cerrahi robot gibi güvenlik kritik sistemlerde bu, basit bir yazılım hatasından çok daha ciddi sonuçlar doğurur.
Darboğazı aşma yöntemleri
| Yaklaşım | Avantaj | Sınırlama |
|---|---|---|
| Veri artırma | Ucuz ve hızlıdır | Yeni sahne bilgisi üretmez |
| Sentetik veri | Otomatik etiket sağlar | Simülasyon-gerçeklik farkı vardır |
| Aktif öğrenme | Yalnızca faydalı örnekleri seçer | Döngüsel insan katkısı ister |
| Yarı denetimli öğrenme | Etiketsiz veriyi kullanır | Hatalı sözde etiket yayılabilir |
| Transfer öğrenmesi | Daha az veriyle başlanır | Kaynak alan uyumsuz olabilir |
Aktif öğrenmede model, en kararsız olduğu görüntüleri insana gönderir. Aşağıdaki basitleştirilmiş örnek, en düşük güvene sahip tahminleri seçer:
def etiketlenecekleri_sec(model, etiketsiz_veri, adet=20):
    # Her örnek için sınıf olasılıklarını hesaplar.
    olasiliklar = model.predict_proba(etiketsiz_veri)

    # En yüksek olasılık düşükse model kararsız kabul edilir.
    guvenler = olasiliklar.max(axis=1)
    indeksler = guvenler.argsort()[:adet]
    return indeksler
Bu yöntem, her görüntüyü etiketlemek yerine öğrenmeye en fazla katkı sağlayacak örneklere odaklanır. Sentetik veriyle birleştiğinde maliyet daha da düşürülebilir. Alan rastgeleleştirme kullanılarak simülasyondaki ışık, doku, kamera açısı ve nesne konumu sürekli değiştirilir; böylece model tek bir yapay görünüme bağlanmaz.
Sonuç
Robotik algılamanın sınırı çoğu zaman model mimarisi değil, verinin kalitesi ve çeşitliliğidir. Daha büyük bir sinir ağı, eksik dünya bilgisini sihirli biçimde tamamlayamaz. Başarılı sistemler; az sayıdaki kaliteli etiketi, bol miktarda etiketsiz veri, simülasyon, aktif öğrenme ve dikkatli saha testleriyle birleştirir. Robotlara görmeyi öğretirken asıl soru “Kaç görüntümüz var?” değil, “Bu görüntüler robotun karşılaşacağı dünyayı ne kadar iyi anlatıyor?” olmalıdır.
Yorumlar