İçindekiler
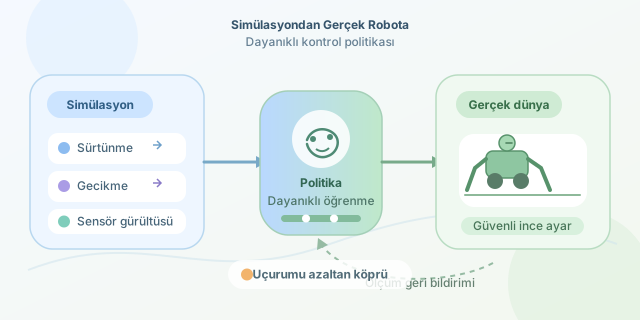
Bir robotun simülasyonda kusursuzca yürümesi, gerçek dünyaya çıktığında aynı zarafetle hareket edeceği anlamına gelmez. Sanal ortamda şampiyon olan kontrol politikası; gerçek motordaki gecikme, zemindeki sürtünme veya sensördeki küçücük bir gürültü yüzünden kendisini yerde bulabilir. Simülasyon ile fiziksel dünya arasındaki bu uyumsuzluğa sim-to-real gap, yani simülasyondan gerçeğe aktarım uçurumu denir.
``
Kontrol politikası ne öğrenir?
Takviyeli öğrenmede robot, bulunduğu durumdan hangi eyleme geçeceğini belirleyen bir politika öğrenir. Bu ilişki genel olarak
\[a_t \sim \pi_\theta(a_t \mid s_t)\]biçiminde gösterilir. Burada $s_t$ robotun eklem açıları, hızları ve sensör ölçümleri gibi durum bilgisini; $a_t$ motorlara gönderilecek komutları; $\theta$ ise öğrenilen parametreleri temsil eder.
Amaç, zaman boyunca elde edilen indirimli ödülü büyütmektir:
\[J(\theta)=\mathbb{E}\left[\sum_{t=0}^{T}\gamma^t r_t\right]\]Robot dengede kalmak, hedefe ilerlemek veya enerji tüketimini azaltmak gibi davranışları ödül fonksiyonu üzerinden keşfeder. Simülasyon bu süreç için idealdir; robot binlerce kez düşebilir, duvara çarpabilir ve yeniden başlatılabilir. Ne teknisyen üzülür ne de pahalı bir dişli kutusu kırılır.
Uçurum neden oluşur?
Simülatörler gerçekliğin eksiksiz kopyası değil, hesaplanabilir modelleridir. Gerçek dünyadaki temas dinamikleri, kablo esnekliği, motor sıcaklığı ve kamera ışığı gibi ayrıntıların tamamını modellemek zordur.
| Etken | Simülasyonda | Gerçek dünyada |
|---|---|---|
| Sürtünme | Sabit veya basitleştirilmiş | Yüzeye ve aşınmaya göre değişken |
| Sensörler | Temiz ve düzenli veri | Gürültü, sapma ve veri kaybı |
| Motorlar | Komuta anında yanıt | Gecikme, doygunluk ve ısınma |
| Temas | Matematiksel yaklaşım | Darbe, titreşim ve deformasyon |
| Görüntü | Kontrollü ışık | Gölge, yansıma ve hareket bulanıklığı |
Politika simülatörün kusurlarını kullanmayı da öğrenebilir. Örneğin gerçek dışı bir temas modelinden yararlanarak yürüyen robot, fiziksel zeminde aynı numarayı yapamaz. Bu durum, adeta sınav sorularını ezberleyip konuyu öğrenmemeye benzer.
Domain randomization: Gerçekliği tahmin etmek yerine çeşitlendirmek
En yaygın çözüm, eğitim sırasında fiziksel parametreleri rastgele değiştiren domain randomization yaklaşımıdır. Robot her bölümde farklı sürtünme, kütle, gecikme ve sensör gürültüsü görür. Böylece tek bir sanal dünyaya ezber yapmak yerine dayanıklı bir strateji geliştirir.
import random

# Her eğitim bölümünde yeni fiziksel koşullar üretir.
def randomize_environment(sim):
    sim.friction = random.uniform(0.4, 1.2)
    sim.motor_strength = random.uniform(0.85, 1.15)
    sim.sensor_noise = random.uniform(0.0, 0.03)
    sim.control_delay = random.randint(0, 3)

for episode in range(10_000):
    randomize_environment(sim)
    observation = sim.reset()
    train_policy(observation)
Bu kod, politikanın belirli bir sürtünme katsayısına güvenmesini engeller. Ancak aralıklar aşırı geniş seçilirse öğrenme gereksiz yere zorlaşır; dar seçilirse gerçek dünya aralığın dışında kalabilir.
Diğer köprü kurma yöntemleri
Sistem tanımlama, gerçek robot üzerinde ölçümler yaparak kütle, motor tepkisi ve sürtünme gibi parametreleri tahmin eder. Domain adaptation, özellikle kamera görüntülerindeki sanal-gerçek farkını azaltır. Gerçek dünyada ince ayar ise simülasyonda öğrenilen politikayı az miktarda fiziksel deneyimle günceller.
| Yöntem | Güçlü yanı | Temel riski |
|---|---|---|
| Domain randomization | Sağlam ve genellenebilir politika | Eğitim zorlaşabilir |
| Sistem tanımlama | Daha gerçekçi simülatör | Parametreler zamanla değişebilir |
| Domain adaptation | Görsel farkları azaltır | Ek veri ve model gerekir |
| Gerçek ince ayar | Doğrudan uyum sağlar | Donanım hasarı riski taşır |
Pratikte en iyi sonuç genellikle bu tekniklerin birleşiminden gelir. Önce geniş bir simülasyon dağılımında eğitim yapılır, ardından güvenlik sınırlarıyla gerçek robot üzerinde dikkatli ince ayar uygulanır. Kısacası hedef, mükemmel bir simülatör yapmak değil; kusurlu simülasyona rağmen doğru karar verebilen bir robot yetiştirmektir.
Yorumlar