İçindekiler
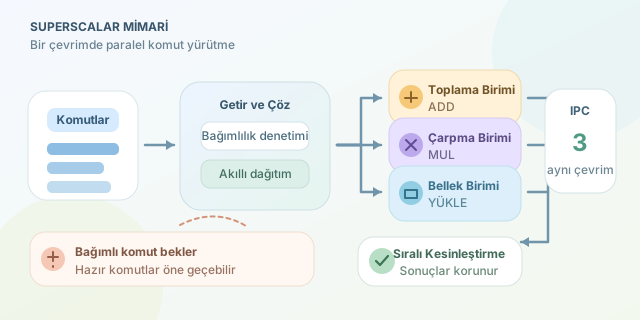
Klasik bir işlemciyi her çevrimde tek iş yapan bir aşçı gibi düşünebiliriz. Superscalar işlemci ise aynı mutfakta birden fazla çalışma tezgâhı kullanır: biri toplama yaparken diğeri bellekten malzeme getirir, bir başkası koşulu kontrol eder. Böylece uygun komutlar, tek bir saat çevrimi içinde farklı yürütme birimlerinde eş zamanlı olarak ilerleyebilir.
``
Temel fikir: Daha hızlı saat değil, daha geniş işlem
Superscalar mimarinin amacı yalnızca saat frekansını yükseltmek değildir. İşlemci, komut akışındaki komut düzeyinde paralelliği yani ILP’yi (Instruction-Level Parallelism) bulmaya çalışır. Birbirinden bağımsız komutlar varsa bunlar aynı çevrimde farklı yürütme birimlerine gönderilebilir.
Örneğin aşağıdaki komutları ele alalım:
ADD R1, R2, R3    ; R1 = R2 + R3
MUL R4, R5, R6    ; R4 = R5 * R6
LOAD R7, [R8]     ; Bellekten R7'ye veri yükle
Bu üç komut farklı kaynakları kullanıyor ve aralarında veri bağımlılığı bulunmuyor. İşlemcide bir toplama birimi, bir çarpma birimi ve bir yükleme birimi varsa komutlar teorik olarak aynı çevrimde başlatılabilir.
İşlemcinin teorik komut verimi kabaca şöyle ifade edilebilir:
\[IPC = \frac{\text{tamamlanan komut sayısı}}{\text{saat çevrimi sayısı}}\]Scalar bir tasarım ideal durumda $IPC \approx 1$ sunarken dört yollu superscalar bir işlemcinin teorik üst sınırı $IPC = 4$ olabilir. Ancak gerçek programlarda bağımlılıklar, önbellek kaçırmaları ve dallanmalar nedeniyle bu sınıra sürekli ulaşılamaz.
Pipeline ile superscalar aynı şey mi?
Hayır. Pipeline, farklı komutların farklı aşamalarda bulunmasını sağlar; superscalar ise aynı aşamada birden fazla komutun işlenebilmesini hedefler.
| Özellik | Pipeline | Superscalar |
|---|---|---|
| Temel amaç | Aşamaları üst üste bindirmek | Çevrim başına birden fazla komut yürütmek |
| Komut genişliği | Genellikle aşama başına bir | Aşama başına birden fazla |
| Gereksinim | Aşamalı veri yolu | Birden fazla yürütme birimi |
| Ana kazanç | Daha yüksek komut akışı | Daha yüksek IPC |
Modern işlemciler genellikle iki yaklaşımı birlikte kullanır. Yani mutfakta hem üretim bandı vardır hem de her istasyonda birden fazla çalışan bulunur.
Bağımlılıklar neden sorun çıkarır?
Her komut paralel çalıştırılamaz. Şu örnekte ikinci komut, birincinin sonucunu beklemek zorundadır:
ADD R1, R2, R3    ; Önce R1 hesaplanır
MUL R4, R1, R5    ; Ardından R1 kullanılır
Bu ilişkiye RAW (Read After Write) veri bağımlılığı denir. Matematiksel olarak ikinci işlem
\[R4 = (R2 + R3) \times R5\]olduğu için çarpma erkenden tamamlanamaz. İşlemci bağımsız başka komutlar bulursa boş yürütme birimlerini onlarla doldurabilir.
| Engel | Açıklama | Yaygın çözüm |
|---|---|---|
| Veri bağımlılığı | Bir komut önceki sonucu bekler | Komut zamanlama |
| İsim bağımlılığı | Aynı yazmaç adı tekrar kullanılır | Register renaming |
| Dallanma | Sonraki komutun adresi belirsizdir | Branch prediction |
| Bellek gecikmesi | Veri önbellekte bulunmaz | Cache ve önceden getirme |
Sıra dışı yürütme
Birçok superscalar işlemci out-of-order execution kullanır. Komutlar program sırasıyla alınır; fakat hazır olanlar, daha eski bir komut beklerken öne geçip çalıştırılabilir.
1. LOAD R1, [adres]   -> Belleği bekliyor
2. ADD  R2, R3, R4    -> Hazır, hemen çalışabilir
3. MUL  R5, R1, R6    -> LOAD sonucunu bekliyor
Burada ikinci komutun birinciyi geçmesi programın sonucunu değiştirmez. Sonuçlar genellikle bir yeniden sıralama tamponu sayesinde mimari durumu bozmadan program sırasıyla kesinleştirilir.
Sonuç
Superscalar işlemciler tek bir komutu sihirli biçimde parçalamaz; bağımsız komutları bulur, uygun yürütme birimlerine dağıtır ve aynı çevrimde birlikte başlatır. Başarı; geniş komut getirme ve çözme mekanizmalarına, doğru dallanma tahminine, register renaming’e, sıra dışı yürütmeye ve hızlı önbelleklere bağlıdır. Kısacası yüksek performans, yalnızca daha hızlı koşmaktan değil, aynı anda daha fazla işi akıllıca organize etmekten gelir.
Yorumlar