İçindekiler
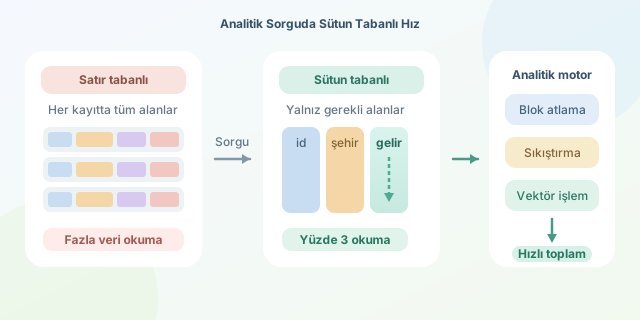
Bir milyar satış kaydının yalnızca toplam gelirini hesaplamak istediğinizi düşünün. Satır tabanlı bir sistem her kaydın ürün, müşteri, adres ve açıklama gibi ilgisiz alanlarını da okuyabilir. Sütun tabanlı depolama ise doğrudan gelir sütununa gider. Analitik sorguların göz açıp kapayıncaya kadar bitmesinin temelinde bu seçicilik yatar.
``
Satırlar yerine sütunlar yan yana
Satır tabanlı depolamada bir kaydın tüm alanları fiziksel olarak birbirine yakın tutulur:
[1, Ankara, 1200] [2, İzmir, 850] [3, Ankara, 940]
Sütun tabanlı düzende ise aynı alana ait değerler birlikte saklanır:
id:     [1, 2, 3]
şehir:  [Ankara, İzmir, Ankara]
tutar:  [1200, 850, 940]
Bu fark yalnızca dosyanın görünümünü değiştirmez; disk erişimini, sıkıştırmayı ve CPU kullanımını doğrudan etkiler.
| Özellik | Satır tabanlı | Sütun tabanlı |
|---|---|---|
| Fiziksel yerleşim | Kaydın tüm alanları birlikte | Aynı sütunun değerleri birlikte |
| Güçlü olduğu alan | OLTP, tekil kayıt işlemleri | OLAP, raporlama ve agregasyon |
| Sütun seçimi | Gereksiz alanlar okunabilir | Yalnızca gerekli alanlar okunur |
| Sıkıştırma | Orta düzey | Genellikle çok yüksek |
| Güncelleme | Hızlı ve doğal | Daha maliyetli olabilir |
Daha az veri okumak neden önemlidir?
Bir tabloda 100 sütun bulunduğunu, sorgunun ise yalnızca 3 sütuna ihtiyaç duyduğunu varsayalım. Sütunların benzer boyutta olduğu basitleştirilmiş durumda okuma oranı şöyledir:
\[R = 3 / 100 = 0.03\]Yani toplam verinin yaklaşık yüzde 3’ü okunur. Sorgu süresini kabaca modellemek istersek:
\[T \approx D / B + C\]Burada $D$ okunan veri miktarı, $B$ depolama bant genişliği, $C$ ise CPU maliyetidir. Sütunlu format $D$ değerini küçülttüğünde diskten ya da nesne depolamadan veri taşıma süresi dramatik biçimde azalır.
Sıkıştırmanın gizli süper gücü
Aynı sütundaki değerler çoğunlukla benzer veri tipine ve dağılıma sahiptir. Örneğin şehir sütununda birkaç isim sürekli tekrar edebilir. Bu düzen sözlük kodlama, run-length encoding ve delta encoding gibi yöntemleri oldukça verimli kılar.
| Teknik | Uygun veri | Temel fikir |
|---|---|---|
| Dictionary encoding | Tekrarlanan metinler | Metin yerine küçük bir kod saklar |
| Run-length encoding | Ardışık aynı değerler | Değer ve tekrar sayısını tutar |
| Delta encoding | Sıralı sayılar veya tarihler | Değerler arasındaki farkı saklar |
Daha iyi sıkıştırma yalnızca disk alanından kazandırmaz. Diske daha az bayt gider, önbelleğe daha çok değer sığar ve bellek trafiği azalır. Açma maliyeti olsa bile modern işlemciler bunu çoğu zaman veri okumaktan daha hızlı gerçekleştirir.
Vektörleştirme ve akıllı atlama
Sütun değerleri ardışık ve aynı tipte olduğundan CPU, birer birer kayıt işlemek yerine değer grupları üzerinde çalışabilir. SIMD komutlarıyla aynı anda birden fazla sayı toplanabilir veya karşılaştırılabilir. Ayrıca Parquet gibi formatlar her veri grubuna ait minimum ve maksimum değerleri saklar.
SELECT region, SUM(amount) AS revenue
FROM sales
WHERE sale_date >= DATE '2026-01-01'
GROUP BY region;
Bu sorgu için motor yalnızca region, amount ve sale_date sütunlarını okur. Bir veri bloğunun en büyük tarihi 2025’te kalıyorsa blok tamamen atlanır. Buna predicate pushdown ve istatistik tabanlı eleme denir. Önce filtre uygulanıp gerekli değerlerin daha sonra getirilmesi ise late materialization yaklaşımıdır.
Her durumda sütun mu?
Hayır. Bir kullanıcının tek kaydını getirip hemen güncelleyen işlemsel uygulamalarda satır tabanlı depolama daha uygundur. Sütunlu sistemler toplu ekleme, tarama, filtreleme ve agregasyonda parlar; sık yapılan küçük güncellemelerde ek birleştirme maliyetleri doğurabilir.
Kısacası hız tek bir numaradan gelmez: daha az sütun okuma, güçlü sıkıştırma, blok atlama, CPU önbelleği ve vektörleştirme birlikte çalışır. Analitik motor, samanlığın tamamını taşımak yerine yalnızca iğnenin bulunduğu kutuyu açar.
Yorumlar