İçindekiler
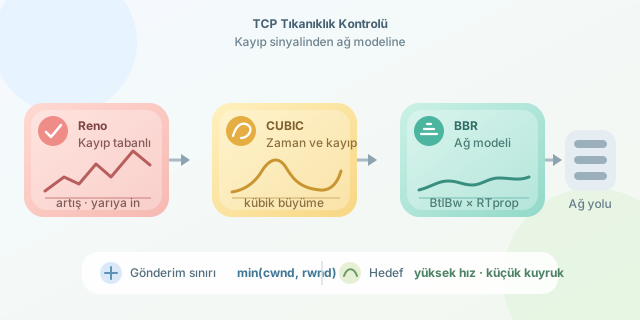
Bir TCP bağlantısı, verileri mümkün olduğunca hızlı göndermek ister; fakat ağın gerçek kapasitesini doğrudan bilemez. Fazla temkinli davranırsa bant genişliği boşa gider, fazla saldırgan davranırsa yönlendirici kuyrukları dolar ve paketler kaybolur. TCP tıkanıklık kontrolü algoritmaları, işte bu görünmez sınırı tahmin etmeye çalışan trafik polisleridir. Reno’dan BBR’a uzanan yolculuk ise kaybı izlemekten ağ modellemeye geçişin hikâyesidir.
``
Temel kavram: Uçuşta kaç paket var?
TCP, onaylanmadan ağda bulunabilecek veri miktarını tıkanıklık penceresi, yani cwnd ile sınırlar. Alıcının ilan ettiği pencere rwnd ise gönderim sınırı yaklaşık olarak şöyledir:
Bir bağlantının kapasitesini anlamada bant genişliği-gecikme çarpımı da önemlidir:
\[BDP = Bant\ Genişliği \times RTT\]Örneğin 100 Mbit/s kapasiteli ve 40 ms RTT değerine sahip bir yolun BDP’si yaklaşık 500 KB’tır. Uçuşta bundan çok daha az veri varsa hat tam kullanılamaz. Çok daha fazlası varsa paketler kuyruklarda bekleyerek bufferbloat oluşturabilir.
Reno: Paket kaybı frene bas demektir
TCP Reno, ağı doğrudan ölçmek yerine paket kaybını tıkanıklık işareti kabul eder. Başlangıçta slow start uygulanır ve cwnd, her RTT’de yaklaşık iki katına çıkar. İsim biraz yanıltıcıdır; bu aşama aslında oldukça hızlıdır.
Eşik aşıldığında congestion avoidance başlar. Reno burada AIMD yaklaşımını kullanır:
- Additive Increase: Kayıp yoksa pencere yavaşça büyür.
- Multiplicative Decrease: Kayıp varsa pencere yaklaşık yarıya iner.
Basitleştirilmiş davranış şu şekilde modellenebilir:
\[cwnd \leftarrow cwnd + \frac{1}{cwnd}\]Paket kaybında ise:
\[cwnd \leftarrow \frac{cwnd}{2}\]Aşağıdaki Python kodu, Reno’nun testere dişine benzeyen pencere hareketini küçük ölçekte canlandırır:
cwnd = 2
loss_rounds = {6, 11}

for round_no in range(1, 15):
    if round_no in loss_rounds:
        cwnd = max(cwnd // 2, 1)  # Kayıpta sert fren
        event = "paket kaybı"
    else:
        cwnd += 1                 # Kontrollü büyüme
        event = "normal artış"

    print(round_no, cwnd, event)
Gerçek TCP uygulaması daha karmaşıktır; üç yinelenen ACK, hızlı yeniden iletim ve zaman aşımı gibi olayları ayrı değerlendirir. Yine de kod, Reno’nun temel refleksini gösterir.
CUBIC: Yüksek hızlı ağlara uygun büyüme
Reno, yüksek bant genişlikli ve uzun gecikmeli bağlantılarda kayıptan sonra eski hızına çok yavaş dönebilir. Linux’un uzun süre varsayılan tercihi olan CUBIC, pencereyi zamana bağlı kübik bir fonksiyonla büyütür:
\[W(t) = C(t-K)^3 + W_{max}\]Burada $W_{max}$ kayıptan önceki pencereyi, $K$ bu seviyeye dönüş süresini temsil eder. CUBIC önce hızlı büyür, eski sınıra yaklaşırken sakinleşir ve kapasite varsa yeniden hızlanır. Böylece büyük BDP değerine sahip bağlantıları Reno’dan daha verimli kullanabilir.
BBR: Kaybı değil, ağı modelle
Google tarafından geliştirilen BBR, paket kaybını tıkanıklığın zorunlu kanıtı saymaz. Bunun yerine teslimat hızını ve en düşük RTT değerini ölçerek iki temel değişken tahmin eder:
\[Tahmini\ Uçuş\ Verisi \approx BtlBw \times RTprop\]BtlBw darboğaz bant genişliği, RTprop ise yolun kuyruksuz gecikme tahminidir. BBR gönderim hızını bu modele göre ayarlayarak yüksek aktarım hızı ile küçük kuyrukları aynı anda hedefler. Ancak diğer algoritmalarla adil paylaşım, ölçüm doğruluğu ve farklı BBR sürümlerinin davranışları hâlâ aktif araştırma konularıdır.
| Algoritma | Ana sinyal | Güçlü yanı | Temel risk |
|---|---|---|---|
| Reno | Paket kaybı | Basit ve öngörülebilir | Büyük BDP’de yavaş toparlanma |
| CUBIC | Kayıp ve zaman | Yüksek hızlı ağlarda verim | Kuyrukları büyütebilme |
| BBR | Bant genişliği ve RTT | Düşük gecikme, yüksek kullanım | Adalet ve model hassasiyeti |
Hangisi daha iyi?
Tek bir mutlak kazanan yoktur. Reno öğretici ve muhafazakâr, CUBIC genel internet trafiğinde güçlü, BBR ise özellikle kayıplı veya uzun mesafeli bağlantılarda etkileyicidir. Seçim yaparken yalnızca indirme hızına değil; RTT, yeniden iletim oranı, kuyruk gecikmesi ve diğer akışlarla adil paylaşım gibi ölçümlere de bakılmalıdır. Çünkü iyi tıkanıklık kontrolü, gaza en çok basan değil, yolun ritmini en doğru okuyandır.
Yorumlar