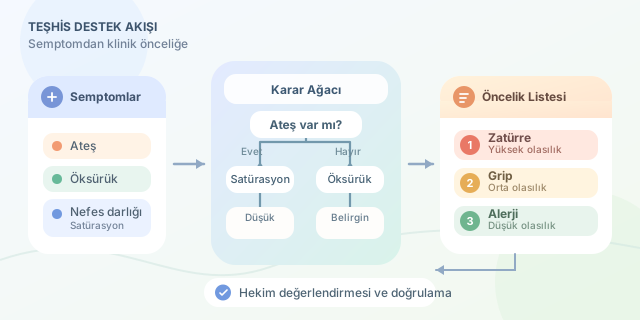
Ateş, öksürük ve nefes darlığı aynı anda görüldüğünde sistem hangi hastalığı önce değerlendirmelidir? Tıbbi teşhis destek sistemlerindeki karar ağaçları, semptomları dallara ayırarak bu soruya açıklanabilir ve denetlenebilir yanıtlar üretir. Ancak amaç doktorun yerine geçmek değil, olası hastalıkları klinik inceleme için önceliklendirmektir. ``
Karar ağacının temel mantığı
Karar ağacı, hasta özellikleri üzerinde art arda sorular sorar. Her düğüm bir koşulu, dal koşulun sonucunu, yaprak ise hastalık sınıfını veya risk puanını temsil eder. Örneğin ilk soru “Ateş var mı?”, sonraki soru “Oksijen satürasyonu düşük mü?” olabilir.
Bu yapı klasik uzman sistemlerde hekimlerin tanımladığı kurallarla kurulabilir. Makine öğrenmesi yaklaşımında ise model, geçmiş hasta kayıtlarından hangi soruların daha ayırt edici olduğunu öğrenir. Ağacın iyi bir soru seçmesi için safsızlık ölçüleri kullanılır.
Entropi şu şekilde hesaplanır:
\[H(S)=-\sum_{i=1}^{k} p_i\log_2(p_i)\]Burada $p_i$, veri kümesindeki $i$ hastalık sınıfının oranıdır. Bir bölünme sonrasında entropi ne kadar azalırsa soru o kadar bilgilendiricidir. Alternatif olarak Gini safsızlığı kullanılabilir:
\[Gini(S)=1-\sum_{i=1}^{k}p_i^2\]| Ölçüt | Temel fikir | Avantaj | Kullanım |
|---|---|---|---|
| Entropi | Belirsizliği ölçer | Bilgi kuramsal yorumu güçlüdür | ID3 ve C4.5 |
| Gini | Sınıfların karışıklığını ölçer | Hesaplaması daha hızlıdır | CART |
| Hata oranı | Yanlış sınıflandırmayı ölçer | Kolay yorumlanır | Model değerlendirme |
Semptomlardan hastalık önceliğine
Bir teşhis destek sistemi yalnızca “grip” gibi tek bir cevap vermemelidir. Daha güvenli yaklaşım; zatürre, grip ve alerji gibi seçenekleri tahmini olasılıklarıyla sıralamaktır. Yaprak düğümündeki sınıf dağılımı bu amaçla kullanılabilir:
\[P(hastalık_i\mid semptomlar)=\frac{n_i}{N}\]Burada $n_i$, yaprağa ulaşan ilgili hastalık vakalarının; $N$ ise o yapraktaki tüm vakaların sayısıdır. Yine de bu değer doğrudan klinik kesinlik değildir. Yaş, gebelik, kronik hastalıklar ve test sonuçları risk değerlendirmesini değiştirebilir.
Aşağıdaki örnek, eğitim amacıyla hazırlanmış basitleştirilmiş bir sınıflandırıcıdır:
from sklearn.tree import DecisionTreeClassifier

# ateş, öksürük, nefes darlığı, düşük satürasyon
X = [
    [1, 1, 0, 0],
    [1, 1, 1, 1],
    [0, 1, 0, 0],
    [1, 0, 1, 1],
    [0, 1, 1, 0]
]
y = ['grip', 'zatürre', 'alerji', 'zatürre', 'alerji']

model = DecisionTreeClassifier(
    criterion='entropy',
    max_depth=3,
    class_weight='balanced',
    random_state=42
)
model.fit(X, y)

hasta = [[1, 1, 1, 0]]
print(model.classes_)
print(model.predict_proba(hasta))
Kod, semptomları ikili özellikler olarak işler ve hastalıkların olasılık dağılımını üretir. max_depth ağacın ezberlemesini sınırlar; class_weight='balanced' ise az görülen sınıfların tamamen göz ardı edilmesini azaltır. Gerçek sistemlerde bu birkaç satırlık örnek yerine doğrulanmış, anonimleştirilmiş ve çok daha kapsamlı klinik veriler gerekir.
Güçlü ve riskli yönler
| Güçlü yön | Klinik karşılığı | Olası risk |
|---|---|---|
| Açıklanabilir kurallar | Hekim karar yolunu görebilir | Aşırı basitleştirme |
| Hızlı tahmin | Triyaj sürecini destekler | Yanlış güven hissi |
| Eksik değerlere uyarlanabilirlik | Her test zorunlu olmayabilir | Sistematik veri eksikliği |
| Özellik önemleri | Etkili semptomlar incelenebilir | Korelasyonu nedensellik sanma |
En kritik sorunlardan biri sınıf dengesizliğidir. Nadir fakat tehlikeli bir hastalık az sayıda örnek içerdiğinde model onu öğrenemeyebilir. Bu nedenle yalnızca doğruluk değil; duyarlılık, özgüllük ve özellikle yanlış negatif oranı izlenmelidir. Budama, çapraz doğrulama ve bağımsız hastane verileriyle dış doğrulama da aşırı öğrenmeyi azaltır.
Sonuç olarak karar ağaçları, “Bu öneri neden üretildi?” sorusuna anlaşılır cevap verebildikleri için sağlık bilişiminde değerlidir. Fakat kaliteli veri, klinik doğrulama, gizlilik, yanlılık denetimi ve insan gözetimi olmadan güvenli teşhis araçlarına dönüşemezler. En doğru rol, hekime rakip olmak değil; önemli ihtimallerin gözden kaçmasını önleyen dikkatli bir yardımcı olmaktır.
Yorumlar