İçindekiler
Transformer modelleri cümledeki kelimeler arasındaki ilişkileri dikkat mekanizmasıyla başarıyla yakalar. Ancak küçük bir sorun vardır: Saf attention işlemi, kelimelerin hangi sırada geldiğini doğal olarak bilmez. Yani model için “Kedi fareyi kovaladı” ile “Fare kediyi kovaladı” başlangıçta aynı kelime koleksiyonu gibi görünebilir. Positional encoding, modele kelimelerin cümledeki konumlarını matematiksel bir pusulayla göstererek bu problemi çözer.
``
Attention Neden Sırayı Göremez?
Self-attention mekanizması her token için query, key ve value vektörleri üretir. Temel hesaplama şöyledir:
\[\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]Bu işlem tokenlar arasındaki benzerliği ölçer; fakat “önce” veya “sonra” kavramlarını içeren ayrı bir bileşene sahip değildir. Girdi satırlarının yeri değiştirilirse attention çıktıları da aynı değişime paralel olarak yeniden sıralanır. Dolayısıyla mekanizma, dizilim bilgisini kendiliğinden öğrenmez.
| Özellik | Embedding | Positional encoding |
|---|---|---|
| Neyi temsil eder? | Kelimenin anlamını | Kelimenin konumunu |
| Aynı kelimede değişir mi? | Genellikle hayır | Konuma göre evet |
| Öğrenilebilir olmak zorunda mı? | Genellikle evet | Hayır |
| Modele katkısı | Semantik bilgi | Sıra ve uzaklık bilgisi |
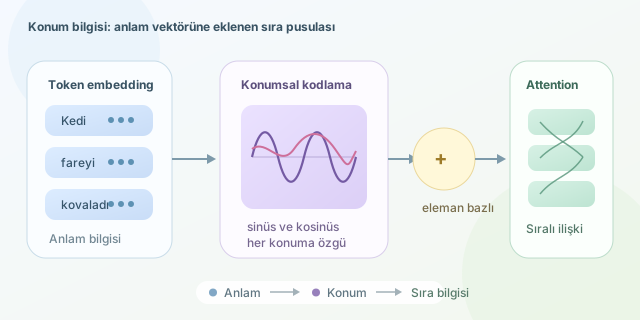
Çözüm, kelime embedding’i ile konum vektörünü toplamaktır:
\[X_{girdi}=E_{token}+P_{konum}\]Böylece aynı kelime farklı konumlarda kullanıldığında attention katmanına farklı bir vektör olarak ulaşır.
Sinüs ve Kosinüs Neden Kullanılıyor?
Orijinal Transformer çalışmasında konumlar, farklı frekanslara sahip sinüs ve kosinüs dalgalarıyla kodlanır:
\[PE(pos,2i)=\sin\left(\frac{pos}{10000^{2i/d_{model}}}\right)\] \[PE(pos,2i+1)=\cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)\]Burada $pos$ tokenın sıradaki yerini, $i$ vektör boyutunu ve $d_{model}$ embedding genişliğini belirtir. Çift indekslerde sinüs, tek indekslerde kosinüs kullanılır. Her boyut farklı frekansta salındığı için her konum kendine özgü bir dalga parmak izi kazanır.
Bunu çok kollu bir saat gibi düşünebiliriz. Bir kol hızlı, diğeri yavaş döner. Tek bir kol zaman zaman aynı noktaya gelse bile bütün kolların oluşturduğu desen uzun süre benzersiz kalır.
| Yaklaşım | Avantaj | Dezavantaj |
|---|---|---|
| Sinüzoidal kodlama | Parametre gerektirmez, uzun dizilere genellenebilir | Göreve özel uyarlanmaz |
| Öğrenilebilir konum vektörü | Veriye göre optimize edilir | Eğitimde görülmeyen uzunluklarda zorlanabilir |
| Relative encoding | Tokenlar arası mesafeyi doğrudan modeller | Uygulaması daha karmaşıktır |
Python ile Basit Uygulama
Aşağıdaki kod, belirli uzunluk ve embedding boyutu için sinüzoidal positional encoding matrisi üretir:
import numpy as np

def positional_encoding(length, d_model):
    positions = np.arange(length)[:, np.newaxis]
    dimensions = np.arange(d_model)[np.newaxis, :]

    rates = 1 / np.power(
        10000,
        (2 * (dimensions // 2)) / d_model
    )
    angles = positions * rates

    encoding = np.zeros((length, d_model))
    encoding[:, 0::2] = np.sin(angles[:, 0::2])
    encoding[:, 1::2] = np.cos(angles[:, 1::2])
    return encoding

pe = positional_encoding(length=10, d_model=8)
print(pe.shape)  # (10, 8)
positions satırlarda token konumlarını, dimensions ise embedding boyutlarını temsil eder. rates, her boyutun ne kadar hızlı salınacağını belirler. Sonuçta her satır farklı bir konum vektörüdür ve bu matris token embedding’lerine eleman bazında eklenebilir.
Göreli Konum Fikri
Sinüzoidal yapı yalnızca mutlak konumu göstermekle kalmaz; konumlar arasındaki farkların anlaşılmasını da kolaylaştırır. Trigonometrik özdeşlikler sayesinde $PE(pos+k)$, $PE(pos)$ üzerinden doğrusal ilişkilerle ifade edilebilir. Böylece model “üç kelime önce” gibi uzaklık örüntülerini öğrenebilir.
Modern mimariler RoPE, ALiBi ve relative positional bias gibi yöntemler de kullanır. Yine de temel fikir değişmez: Attention kelimelerin birbirine ne kadar baktığını söylerken positional encoding, bu kelimelerin sahnede nerede durduğunu bildirir. Anlam oyuncularsa, konum bilgisi koreografidir; biri eksik olduğunda cümlenin dansı kolayca karışır.
Yorumlar