İçindekiler
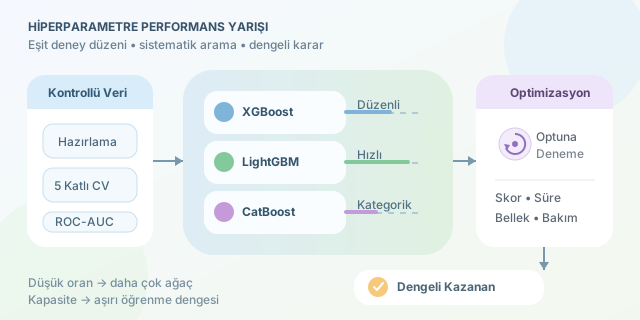
Gradient boosting ailesi, tabular verilerdeki güçlü performansıyla veri biliminin Formula 1 aracı gibidir: doğru ayarlarla inanılmaz hızlıdır, yanlış ayarla ise duvara çarpması kolaydır. XGBoost, LightGBM ve CatBoost aynı temel fikri paylaşsa da ağaçları büyütme stratejileri, kategorik veriye yaklaşımları ve düzenlileştirme seçenekleri farklıdır. Bu nedenle adil bir karşılaştırma, varsayılan parametrelerle değil; kontrollü veri hazırlama, çapraz doğrulama ve sistematik hiperparametre optimizasyonu ile yapılmalıdır.
``
Teorik temel: Hatalardan öğrenen ağaçlar
Gradient boosting, modelleri ardışık biçimde kurar. Her yeni karar ağacı, önceki ağaçların açıklayamadığı hatalara odaklanır. Genel tahmin şu şekilde yazılabilir:
\[\hat{y}(x) = \sum_{t=1}^{T} \eta f_t(x)\]Burada $f_t$ t’inci ağaç, $T$ ağaç sayısı ve $\eta$ ise öğrenme oranıdır. Amaç, kayıp fonksiyonunu küçültürken modelin gereğinden karmaşıklaşmasını engellemektir:
\[\mathcal{L} = \sum_i l(y_i, \hat{y}_i) + \Omega(f)\]$\Omega(f)$ düzenlileştirme terimidir; derinliği, yaprak sayısını veya yaprak ağırlıklarını sınırlayarak ezberlemeyi azaltır. Kritik denge şudur: düşük $\eta$ genellikle daha fazla ağaç gerektirir, ancak daha kararlı öğrenme sunar.
| Algoritma | Ağaç büyütme yaklaşımı | Öne çıkan avantaj | Dikkat edilmesi gereken |
|---|---|---|---|
| XGBoost | Level-wise, dengeli büyüme | Güçlü düzenlileştirme ve olgun ekosistem | Büyük veride eğitim süresi |
| LightGBM | Leaf-wise, en kazançlı yaprak | Çok hızlı eğitim, düşük bellek kullanımı | Küçük veride aşırı öğrenme riski |
| CatBoost | Simetrik/oblivious ağaçlar | Kategorik değişkenlerde başarılı | Bazı senaryolarda daha yavaş olabilir |
Hangi parametreler pist ayarıdır?
Üç kütüphanede isimler değişse de parametrelerin rolleri benzerdir. learning_rate ve n_estimators birlikte değerlendirilmelidir. XGBoost’ta max_depth, LightGBM’de num_leaves, CatBoost’ta depth model kapasitesini belirler. Satır ve sütun örnekleme parametreleri (subsample, colsample_bytree, feature_fraction) varyansı düşürür. LightGBM için pratik bir kural, yaprak sayısını derinlikle ilişkilendirmektir: $num_leaves \leq 2^{max_depth}$.
| Hedef | XGBoost | LightGBM | CatBoost |
|---|---|---|---|
| Karmaşıklığı azaltmak | max_depth düşür |
num_leaves düşür |
depth düşür |
| Öğrenmeyi yavaşlatmak | learning_rate düşür |
learning_rate düşür |
learning_rate düşür |
| Aşırı öğrenmeyi önlemek | min_child_weight, reg_lambda |
min_child_samples, lambda_l2 |
l2_leaf_reg, random_strength |
| Kategorik veri | Ön işleme gerekir | Kategori tipi belirtilebilir | Doğrudan cat_features |
Optuna ile tekrarlanabilir arama
Grid search, her kombinasyonu denediği için parametre sayısı arttıkça pahalılaşır. Random search daha geniş alan tarar; Bayesian optimizasyon kullanan Optuna ise önceki denemelerden öğrenerek umut vadeden bölgelere yönelir. Aşağıdaki örnek, XGBoost için ROC-AUC skorunu 5 katlı çapraz doğrulama ile optimize eder:
import optuna
from sklearn.model_selection import cross_val_score, StratifiedKFold
from xgboost import XGBClassifier

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

def objective(trial):
    model = XGBClassifier(
        n_estimators=trial.suggest_int("n_estimators", 300, 1200),
        max_depth=trial.suggest_int("max_depth", 3, 10),
        learning_rate=trial.suggest_float("learning_rate", 0.01, 0.2, log=True),
        subsample=trial.suggest_float("subsample", 0.6, 1.0),
        colsample_bytree=trial.suggest_float("colsample_bytree", 0.6, 1.0),
        eval_metric="logloss", random_state=42
    )
    return cross_val_score(model, X, y, cv=cv, scoring="roc_auc").mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=50)
print(study.best_value, study.best_params)
Aynı değerlendirme bölmeleri, aynı metrik ve aynı deneme bütçesi LightGBM ile CatBoost için de kullanılmalıdır. Aksi halde hız veya skor farkı algoritmadan değil, deney düzeninden kaynaklanabilir. Eğitim süresi, validasyon ortalaması ve standart sapmayı birlikte raporlayın. Kategorik sütunları yoğun olan bir veri setinde CatBoost sıkça güçlü bir başlangıçtır; milyonlarca satırda LightGBM hız avantajı sağlar; ayrıntılı kontrol ve taşınabilirlik gerektiğinde XGBoost güvenilir bir seçenektir. Kazananı sadece en yüksek skor değil, gecikme, bellek ve bakım maliyeti belirler.
Yorumlar