İçindekiler
Bir makine öğrenmesi modeli, kendisine sunulan eğitim verilerini sorgulamadan öğrenir. Peki bu verilerin arasına ustaca hazırlanmış yanıltıcı örnekler karıştırılırsa ne olur? Veri zehirlenmesi saldırılarında kötü niyetli kişiler, devasa veri kümelerinin yalnızca küçük bir bölümünü değiştirerek modelin davranışlarını gizlice yönlendirebilir. Başka bir deyişle, aşçı aynı, tarif aynı; fakat birisi baharat kavanozunu sessizce değiştirmiştir.
``
Veri zehirlenmesi nedir?
Veri zehirlenmesi veya data poisoning, saldırganın modelin eğitim sürecini etkilemek amacıyla eğitim verilerini değiştirmesidir. Değişiklik; sahte kayıt ekleme, etiketleri tersine çevirme, bazı özellikleri bozma ya da belirli örneklere gizli bir işaret yerleştirme biçiminde olabilir.
Denetimli öğrenmede model genellikle şu kaybı küçültmeye çalışır:
\[L(θ) = (1/n) Σ_{i=1}^{n} ℓ(f_θ(x_i), y_i)\]Burada $x_i$ girdiyi, $y_i$ etiketi, $f_θ$ modeli ve $ℓ$ tahmin hatasını temsil eder. Saldırgan bazı $(x_i, y_i)$ çiftlerini değiştirince model, farkında olmadan manipüle edilmiş bir hedef fonksiyonunu optimize eder. Zehirli örneklerin oranı düşük olsa bile karar sınırına yakın seçilmeleri etkilerini büyütebilir.
Başlıca saldırı türleri
| Saldırı türü | Amaç | Olası belirti |
|---|---|---|
| Etiket değiştirme | Modelin sınıfları karıştırmasını sağlamak | Belirli sınıflarda doğruluk düşüşü |
| Temiz etiketli saldırı | Doğru görünen örneklerle karar sınırını bozmak | Normal etiketler, sıra dışı özellikler |
| Arka kapı saldırısı | Gizli bir işaret görüldüğünde özel davranış üretmek | Genel başarı yüksekken tetikleyicide hata |
| Kullanılabilirlik saldırısı | Modelin genel performansını düşürmek | Birçok sınıfta yaygın bozulma |
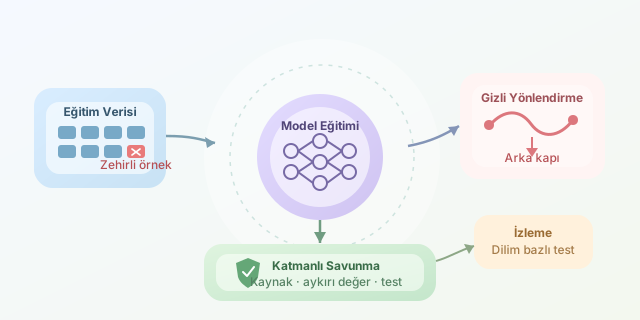
Arka kapı saldırıları özellikle sinsidir. Model normal testlerde başarılı olabilir; ancak belirli bir desen, renk veya veri özelliği ortaya çıktığında saldırganın istediği sınıfı seçer. Bu nedenle yalnızca toplam doğruluğa bakmak güvenlik için yeterli değildir.
Basit bir savunma deneyi
Aşağıdaki Python örneği, eğitim kümesindeki aykırı örnekleri IsolationForest ile işaretler. Bu yöntem saldırıyı kesin olarak kanıtlamaz; incelenmesi gereken kayıtları azaltan bir ön filtre görevi görür.
from sklearn.ensemble import IsolationForest
import numpy as np

# X: eğitim özellikleri, y: sınıf etiketleri
X = np.load("train_features.npy")
y = np.load("train_labels.npy")

scanner = IsolationForest(
    contamination=0.02,
    random_state=42
)
flags = scanner.fit_predict(X)

suspicious = np.where(flags == -1)[0]
print(f"İncelenecek örnek sayısı: {len(suspicious)}")
print("Şüpheli etiketler:", y[suspicious][:10])
Buradaki contamination, şüpheli veri oranına ilişkin bir varsayımdır. Çok yüksek seçilirse temiz kayıtlar gereksiz yere elenir; çok düşük seçilirse zehirli örnekler kaçabilir. Ayrıca gelişmiş saldırılar istatistiksel olarak normal görünebildiğinden bu kontrol tek başına kullanılmamalıdır.
Savunma neden katmanlı olmalı?
| Savunma yaklaşımı | Güçlü yanı | Sınırlaması |
|---|---|---|
| Veri kaynağı doğrulama | Yetkisiz veri girişini engeller | Güvenilir kaynak da ele geçirilebilir |
| Aykırı değer analizi | Bariz anomalileri yakalar | Gizli saldırıları kaçırabilir |
| Etiket denetimi | Yanlış etiketleri bulur | Büyük kümelerde maliyetlidir |
| Dayanıklı eğitim | Zehirli örneklerin etkisini azaltır | Her saldırıya karşı garanti sunmaz |
| Dilim bazlı test | Hedefli bozulmaları görünür kılar | Doğru test dilimleri gerektirir |
Sağlam bir süreçte veri sürümleri hash değerleriyle kaydedilmeli, veri ekleme yetkileri sınırlandırılmalı ve her kaynağın köken bilgisi tutulmalıdır. Model performansı yalnızca ortalama doğrulukla değil; sınıf, kaynak, zaman aralığı ve kritik alt gruplar bazında izlenmelidir.
Sonuç olarak veri zehirlenmesi, model dosyasına dokunmadan modeli manipüle edebilen bir tedarik zinciri saldırısıdır. Güvenli makine öğrenmesi; temiz veri varsayımına güvenmek yerine verinin kimden geldiğini, nasıl değiştiğini ve model davranışını hangi örneklerin etkilediğini sürekli sorgulamalıdır.
Yorumlar