İçindekiler
Kredi kartınızla gece yarısı başka bir ülkede yüksek tutarlı alışveriş yapıldığını düşünün. Bankanın saniyeler içinde işlemi durdurup size bildirim göndermesi sihir değil; geçmiş işlemlerden davranış kalıpları öğrenen makine öğrenmesi sistemlerinin eseridir. Ancak bu sistemlerin görevi yalnızca “garip” işlemleri bulmak değil, gerçek müşterileri gereksiz yere rahatsız etmeden dolandırıcılığı mümkün olduğunca erken yakalamaktır.
``
Problem neden zordur?
Finansal dolandırıcılık tespiti, klasik bir ikili sınıflandırma problemine benzer. Her işlem için model iki olasılıktan birini tahmin eder:
- $y=0$: Normal işlem
- $y=1$: Dolandırıcılık
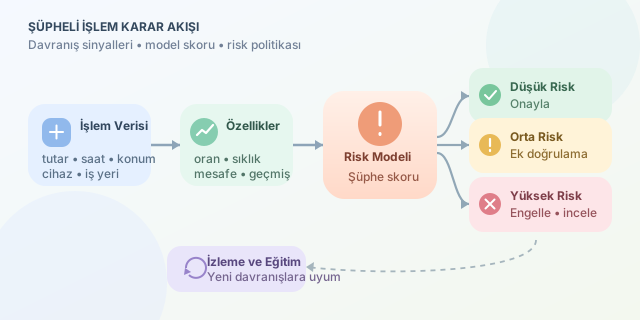
Model; tutar, saat, konum, cihaz, iş yeri kategorisi ve müşterinin geçmiş davranışları gibi özellikleri kullanarak $P(y=1\vert x)$ olasılığını hesaplar. Bu olasılık belirlenen eşikten yüksekse işlem incelemeye gönderilir veya geçici olarak durdurulur.
Asıl sorun, veri kümesinin son derece dengesiz olmasıdır. Bir milyon işlem içinde yalnızca bin dolandırıcılık bulunabilir. Her işleme “normal” diyen tembel bir model, %99,9 doğruluk elde eder; fakat tek bir suçluyu bile yakalayamaz. Yani yüksek accuracy, burada tek başına etkileyici görünen ama pek işe yaramayan bir vitrindir.
| Metrik | Cevapladığı soru | Finansal anlamı |
|---|---|---|
| Precision | Alarm verilen işlemlerin kaçı gerçekten şüpheli? | Gereksiz müşteri engellemelerini azaltır |
| Recall | Dolandırıcılıkların kaçı yakalandı? | Finansal kaybı azaltır |
| F1 skoru | Precision ve recall dengeli mi? | Genel karşılaştırma sağlar |
| ROC-AUC | Model sınıfları ne kadar iyi ayırıyor? | Eşik bağımsız değerlendirme sunar |
Precision ve recall arasındaki denge şu formülle özetlenebilir:
\[F1 = 2 \times \frac{Precision \times Recall}{Precision + Recall}\]Model neye bakar?
Ham işlem verileri çoğu zaman yeterli değildir. Etkili sistemler, davranışı temsil eden yeni özellikler üretir. Örneğin müşterinin son bir saatte yaptığı işlem sayısı, mevcut tutarın ortalama harcamaya oranı veya ardışık işlemler arasındaki coğrafi mesafe hesaplanabilir.
| Normal davranış | Şüpheli davranış |
|---|---|
| Düzenli saatlerde alışveriş | Alışılmadık saatte yüksek harcama |
| Sık kullanılan cihaz | İlk kez görülen cihaz |
| Yakın şehirlerde işlemler | Dakikalar içinde farklı ülkeler |
| Ortalama tutara yakın ödeme | Ortalamanın çok üzerinde ödeme |
Örneğin İstanbul’da yapılan bir işlemin beş dakika ardından Tokyo’da fiziksel kart kullanılması, “imkânsız seyahat” sinyalidir. Yine de tek bir sinyal kesin suç kanıtı değildir. Müşteri VPN kullanıyor, seyahat ediyor veya alışılmadık ama tamamen meşru bir alışveriş yapıyor olabilir.
Hangi algoritmalar kullanılır?
Lojistik regresyon açıklanabilir ve hızlı bir başlangıç modelidir. Karar ağaçları, Random Forest ve özellikle XGBoost gibi yöntemler karmaşık ilişkileri daha iyi yakalayabilir. Etiketlenmiş dolandırıcılık örneklerinin az olduğu durumlarda Isolation Forest veya Autoencoder gibi anomali tespiti yöntemleri devreye girer.
Aşağıdaki örnek, dengesiz sınıflara ağırlık vererek basit bir model eğitir:
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# Az görülen dolandırıcılık sınıfına otomatik olarak daha fazla önem verir.
model = RandomForestClassifier(
    n_estimators=200,
    class_weight='balanced',
    random_state=42
)

model.fit(X_train, y_train)
predictions = model.predict(X_test)
print(classification_report(y_test, predictions))
class_weight='balanced', azınlık sınıfındaki hataların model açısından daha maliyetli olmasını sağlar. Alternatif olarak SMOTE ile sentetik örnek üretilebilir; ancak zaman sıralı finans verilerinde veri sızıntısını önlemek için eğitim ve test ayrımı kronolojik yapılmalıdır.
Gerçek sistemlerde karar nasıl verilir?
Üretim ortamında model genellikle tek başına karar vermez. Model skoru, kural motoru ve risk politikaları birlikte çalışır. Düşük riskli işlem onaylanabilir, orta riskli işlem için ek doğrulama istenebilir, yüksek riskli işlem ise engellenip uzman incelemesine gönderilebilir.
Dolandırıcıların davranışları sürekli değiştiği için model de düzenli olarak izlenmeli ve yeniden eğitilmelidir. Buna concept drift denir. Başarılı bir sistem yalnızca geçmiş suçları ezberlemez; yeni saldırı biçimlerine uyum sağlar, yanlış alarmları kontrol eder ve kararlarının nedenini açıklayabilir. Kısacası makine öğrenmesi dijital bir dedektiftir; fakat iyi veri, doğru metrikler ve insan denetimi olmadan büyüteci ters tutabilir.
Yorumlar