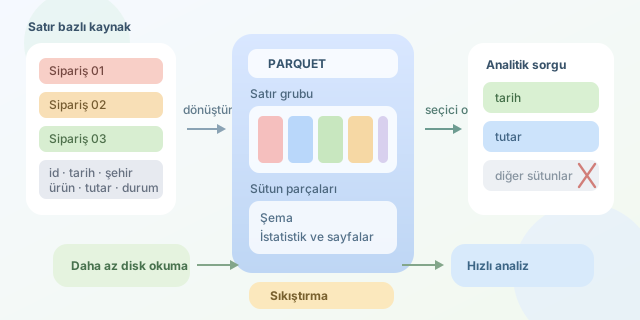
Büyük veri dünyasında yalnızca veriyi saklamak yetmez; onu ekonomik biçimde saklamak ve gerektiğinde ışık hızında okumak gerekir. Parquet, özellikle analitik iş yükleri için tasarlanmış sütun bazlı (columnar) bir dosya formatıdır. CSV gibi satır bazlı formatların aksine, aynı sütuna ait değerleri yan yana tutar. Bu küçük tasarım farkı; daha güçlü sıkıştırma, daha az disk okuması ve Spark, Trino ya da DuckDB gibi araçlarda belirgin performans kazancı anlamına gelir.
``
Bir e-ticaret tablosunu düşünelim: siparis_id, tarih, sehir, urun, tutar ve durum alanları olsun. Analizlerin çoğu toplam ciroyu hesaplarken yalnızca tarih ve tutar sütunlarına ihtiyaç duyar. CSV veya JSON okuyan bir motor, satırlardaki diğer alanları da taramak zorunda kalabilir. Parquet ise sadece gerekli sütun parçalarını okur. Bu yaklaşıma column pruning denir: kullanılmayan sütunlar daha diskten alınmadan elenir.
| Özellik | CSV / JSON | Parquet |
|---|---|---|
| Depolama düzeni | Satır bazlı | Sütun bazlı |
| Şema bilgisi | Genellikle haricî veya zayıf | Dosya içinde saklanır |
| Sıkıştırma | Tüm dosyada sınırlı | Sütun tipine göre verimli |
| Analitik sorgular | Daha fazla I/O | Seçici ve hızlı okuma |
| İnsan tarafından okunabilirlik | Yüksek | Düşük |
Parquet performansının teorik temeli veri yerelliği ve istatistiklerdir. Aynı türden değerler birlikte tutulduğu için tekrar eden şehir adları, kategoriler veya durum kodları çok iyi sıkıştırılır. Örneğin durum alanında yalnızca hazırlanıyor, kargoda ve teslim değerleri varsa sözlük kodlama (dictionary encoding) etkili olur. Metinlerin kendisi yerine küçük sayısal kodlar saklanabilir.
Sıkıştırma oranını kabaca şöyle ifade edebiliriz:
\[R = \frac{S_{ham}}{S_{sıkıştırılmış}}\]Burada $R$ büyüdükçe aynı veri daha az alan kaplar. Ancak hedef yalnızca dosyayı küçültmek değildir. Okuma maliyeti yaklaşık olarak $T = T_{I/O} + T_{CPU}$ biçiminde düşünülebilir. Güçlü sıkıştırma $T_{I/O}$ değerini azaltırken, veriyi açmak için $T_{CPU}$ ekler. Parquet; Snappy, Gzip, ZSTD ve LZ4 gibi codec seçenekleriyle bu dengeyi iş yüküne göre kurmanızı sağlar.
| Codec | Hız | Sıkıştırma oranı | Uygun senaryo |
|---|---|---|---|
| Snappy | Çok yüksek | Orta | Günlük Spark analizleri |
| Gzip | Düşük-orta | Yüksek | Arşivleme ve düşük maliyet |
| ZSTD | Yüksek | Yüksek | Dengeli modern veri gölleri |
| LZ4 | Çok yüksek | Orta | Düşük gecikmeli işlemler |
Parquet dosyası tek parça bir veri akışı değildir. İçinde satır grupları (row groups), sütun parçaları (column chunks), sayfalar (pages) ve metadata bulunur. Metadata; her sütunun türünü, konumunu ve çoğu zaman minimum-maksimum değerlerini taşır. Bir sorgu tarih >= '2026-01-01' şartını kullandığında motor, tarih aralığı uymayan satır gruplarını atlayabilir. Bu optimizasyonun adı predicate pushdown olarak bilinir.
Python ile Pandas ve PyArrow kullanarak basit bir Parquet üretimi şöyledir:
import pandas as pd

siparisler = pd.DataFrame({
    "sehir": ["İzmir", "Ankara", "İzmir"],
    "tutar": [420.0, 175.5, 890.0],
    "durum": ["teslim", "kargoda", "teslim"]
})

siparisler.to_parquet(
    "siparisler.parquet",
    engine="pyarrow",
    compression="zstd",
    index=False
)

sonuc = pd.read_parquet("siparisler.parquet", columns=["sehir", "tutar"])
print(sonuc)
Bu örnekte compression="zstd" dosya boyutu ile okuma hızını dengeler. columns parametresi ise yalnızca ihtiyaç duyulan iki sütunu seçer; gerçek avantaj milyonlarca satır ve onlarca sütun olduğunda görünür.
Yine de Parquet her problem için sihirli değnek değildir. Sürekli tek satır eklenen günlük uygulama kayıtları veya insanın metin editörüyle incelemesi gereken küçük dosyalar için CSV daha pratiktir. En iyi sonuç için veriyi mantıklı klasörlere bölümlendirin: örneğin yil=2026/ay=08/. Çok küçük dosyalardan kaçının, şemayı tutarlı yönetin ve analitik sorgularda sütun seçimini alışkanlık hâline getirin. Böylece Parquet, veri gölünüzün sessiz ama son derece çalışkan motoruna dönüşür.
Yorumlar