Mikro servis mimarisinde servisler birbirinden bağımsız çalışır; ancak işin sihirli kısmı bu servislerin güvenilir ve hızlı biçimde konuşabilmesidir. REST, insan tarafından okunabilir JSON yapısıyla harika bir başlangıç noktasıdır. Buna karşın çok yoğun trafik, düşük gecikme ve güçlü tip güvenliği gerektiğinde gRPC sahneye çıkar. HTTP/2 üzerinde çalışan gRPC, veriyi Protocol Buffers (Protobuf) ile ikili formatta taşıyarak ağdaki gereksiz yükü azaltır.
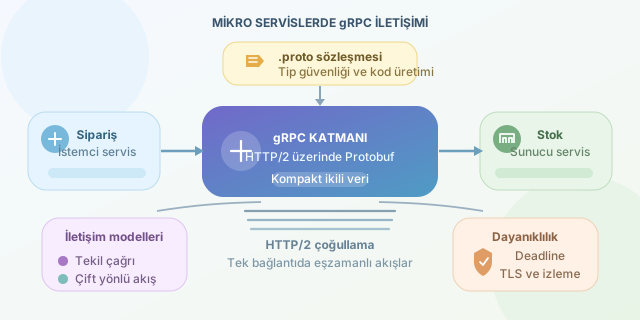
Devamı...
İki uzun polinomu klasik yöntemle çarpmak, her katsayının diğer tüm katsayılarla buluştuğu pahalı bir danstır. Derecesi milyonlara yaklaşan polinomlarda veya binlerce basamaklı tamsayılarda bu dans hızla kabusa dönüşür. Hızlı Fourier Dönüşümü (FFT), çarpma işlemini farklı bir uzaya taşıyarak problemi akıllıca küçültür: çarpmak yerine değerlendirir, noktasal çarpar ve geri dönüştürür.
Devamı...
Bir banka hesabının bugünkü bakiyesini yalnızca tek bir balance alanında tutmak kolaydır; ancak bu değerin nasıl oluştuğunu anlamak zordur. Event Sourcing, sistemin mevcut durumunu doğrudan saklamak yerine, durumu değiştiren olayları kalıcılaştırır. Böylece uygulama geçmişi silmek yerine kaydeder ve istenen anın durumunu olayları tekrar oynatarak oluşturabilir.
Devamı...
Büyük veri analitiği denince çoğu kişinin aklına sunucular, kümeler ve karmaşık veri boru hatları gelir. DuckDB ise bu algıyı tersine çevirir: Uygulamanızın içinde çalışır, tek bir dosyada veriyi saklar ve milyonlarca satırlık CSV ya da Parquet dosyasında oldukça hızlı SQL sorguları koşturabilir. Özellikle veri bilimi, keşifsel analiz ve yerel raporlama işlerinde “küçük ama çok güçlü” bir araçtır.
Devamı...
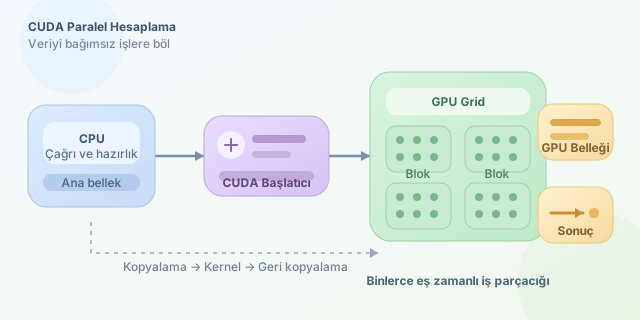
Bilgisayarınızdaki ekran kartı yalnızca oyunlardaki gölgeleri ve piksel efektlerini çizmek için çalışmaz; doğru programlandığında binlerce küçük işlemciyi aynı anda kullanan güçlü bir hesaplama laboratuvarına dönüşür. NVIDIA’nın CUDA platformu, C/C++ bilgisine sahip geliştiricilerin bu paralel güce erişmesini sağlar. Ancak CUDA’yı öğrenmenin anahtarı, daha fazla çekirdek demek yerine, problemi binlerce bağımsız işe nasıl bölebileceğinizi anlamaktır.
Devamı...
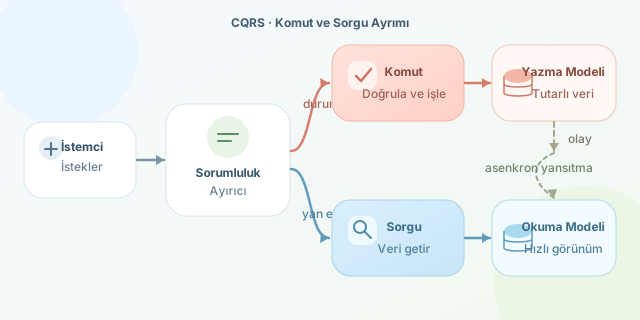
Modern uygulamalarda her isteği aynı veri modeliyle karşılamak başlangıçta pratiktir; ancak kullanıcı sayısı, raporlama ihtiyacı ve işlem yoğunluğu arttıkça bu yaklaşım zorlanır. CQRS (Command Query Responsibility Segregation), yani Komut ve Sorgu Sorumluluklarının Ayrılması, veriyi değiştiren işlemlerle veriyi okuyan işlemleri bilinçli biçimde ayırır. Böylece sistem, “sipariş oluştur” ile “son 30 günün sipariş raporunu göster” gibi tamamen farklı ihtiyaçlara kendi kurallarıyla hizmet eder.
Devamı...
Bir analistin önünde milyarlarca olay kaydı olduğunu düşünün: tıklamalar, siparişler, sensör ölçümleri ve uygulama logları… Klasik satır tabanlı veritabanlarında bu tabloyu taramak bazen kahve molası gerektirir. ClickHouse ise analitik iş yükleri için tasarlanmış sütun tabanlı mimarisiyle, doğru veri modelinde bu molayı birkaç saniyelik bekleyişe dönüştürür. Sırrı yalnızca “hızlı SQL” değildir; veriyi diskten nasıl okuduğu, nasıl sıkıştırdığı ve sorguyu paralel nasıl yürüttüğüdür.
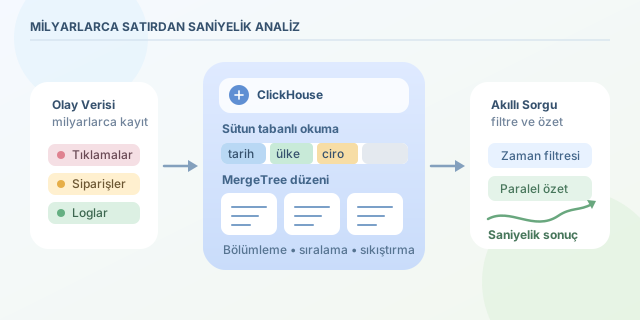
Devamı...
Bir modeli eğitmek saatler sürüyor, laboratuvar deneyi pahalı reaktifler tüketiyor ya da bir simülasyon tek çalıştırmada bulut faturasını kabartıyorsa klasik parametre taraması lükstür. Bayesian optimizasyon (BO), her denemeden öğrendiklerini kullanarak bir sonraki denemeyi stratejik biçimde seçer. Amaç, mümkün olan en az sayıda değerlendirmeyle en iyi parametre kombinasyonuna yaklaşmaktır.
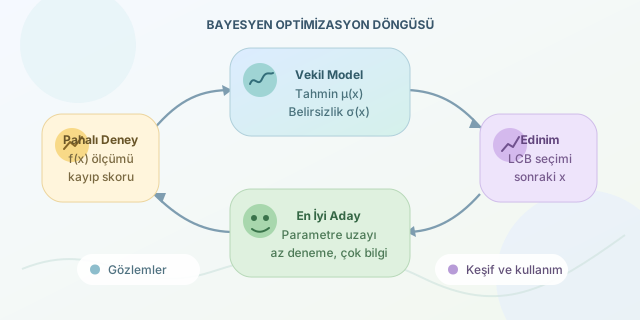
Devamı...
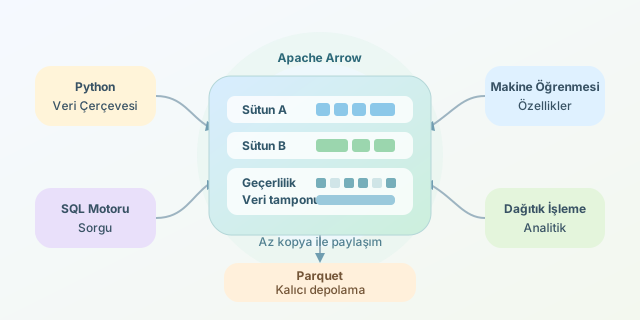
Modern veri ekiplerinde aynı tablo; Python, SQL motorları, veri gölleri ve makine öğrenmesi araçları arasında sürekli taşınır. Sorun şu ki bu araçların her biri veriyi farklı bellek düzenleriyle temsil edebilir. Apache Arrow, bu dönüşüm maliyetini azaltmak için tasarlanmış, dil bağımsız ve bellek içi sütun bazlı bir veri formatıdır. Amaç yalnızca dosya okumayı hızlandırmak değil; analitik araçların veriyi kopyalamadan veya çok az kopyalayarak paylaşabilmesini sağlamaktır.
Devamı...
Bir karınca kolonisinin yiyeceğe giden en kısa rotayı bulması, ilk bakışta basit bir doğa olayı gibi görünür. Ancak binlerce karıncanın bıraktığı ve takip ettiği kimyasal izler, karmaşık optimizasyon problemlerini çözmek için güçlü bir fikir sunar. Ant Colony Optimization (ACO), merkezi bir yöneticiye ihtiyaç duymadan; küçük, basit kuralları izleyen yapay karıncaların kolektif zekâsıyla iyi çözümler üretir. Özellikle rota planlama, çizelgeleme ve ağ yönlendirme problemlerinde oldukça etkilidir.
Devamı...
Bir metin içinde belirli bir deseni aramak, ilk bakışta basit görünür: her konumdan başlayıp karakterleri karşılaştırırız. Ancak uzun metinler ve tekrar eden örüntüler devreye girdiğinde bu yaklaşım pahalılaşır. Z Algoritması, daha önce yapılmış karşılaştırmaları akıllıca yeniden kullanarak örüntü eşleştirmeyi doğrusal zamanda gerçekleştiren zarif bir tekniktir.
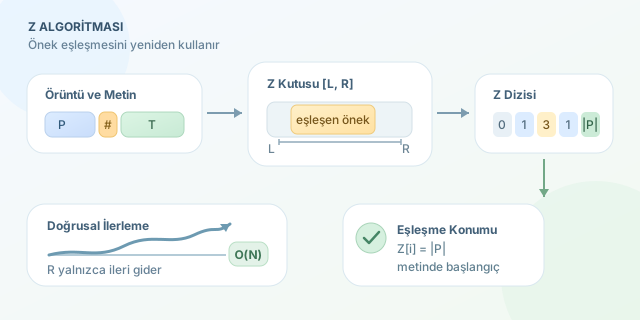
Devamı...
Bir arama kutusuna pro yazdığınızda saniyeler değil, milisaniyeler içinde programlama, proje ve profil önerilerinin belirmesi sihir değildir: sahnenin arkasında çoğu zaman Trie veri yapısı çalışır. Prefix tree olarak da bilinen Trie, kelimeleri karakter karakter dallandırarak saklar. Böylece tüm kelime listesini her tuş vuruşunda baştan sona dolaşmak yerine, yalnızca yazılan öneke karşılık gelen dalı takip ederiz.
Devamı...
Bir ikili arama ağacında (BST) hızlı arama, ekleme ve silme isteriz; ancak anahtarlar sıralı gelirse ağaç bir çubuğa dönüşebilir. Treap, bu talihsiz senaryoyu rastgelelik yardımıyla büyük ölçüde engeller. Adı, tree ve heap kelimelerinin birleşimidir: Anahtarlara göre BST, rastgele önceliklere göre ise heap davranışı sergiler. Böylece AVL veya Kırmızı-Siyah ağaçların katı dengeleme kurallarına alternatif, zarif bir yaklaşım sunar.
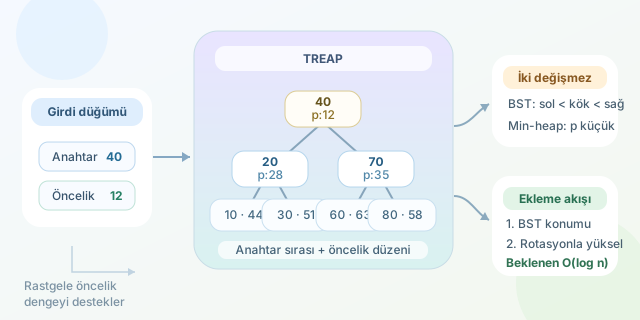
Devamı...
Bir kitap arşivinde, DNA dizisinde ya da milyonlarca log satırında belirli bir ifadeyi aradığınızı düşünün. Klasik yöntemle metni baştan sona taramak çoğu zaman yeterlidir; fakat aynı dev metinde binlerce farklı sorgu çalıştırılacaksa maliyet hızla büyür. Suffix Tree ve Suffix Array, metni bir kez ön işleyip sonraki örüntü aramalarını çok daha hızlı hale getiren iki güçlü veri yapısıdır.
Devamı...
Splay Tree, klasik ikili arama ağacının (BST) heyecanlı ve biraz da inatçı kuzenidir: Bir düğüme eriştiğiniz anda onu ağacın köküne kadar taşımaya çalışır. Amaç, yakın geçmişte sık kullanılan verilere gelecekte daha hızlı ulaşmaktır. Dengeli ağaçlar gibi her an kusursuz görünmek zorunda değildir; bunun yerine kullanım alışkanlıklarınızı öğrenir.
Devamı...
Bir dizideki belirli aralıkların minimumunu, maksimumunu ya da EBOB’unu defalarca bulmanız gerektiğini düşünün. Veri hiç değişmiyorsa, her sorguda aralığı baştan taramak gereksiz bir maliyettir. Sparse Table, ön işlem süresini ve belleği göze alarak sorguları özellikle minimum/maksimum gibi işlemlerde $O(1)$ sürede cevaplayan etkileyici bir veri yapısıdır. Adındaki “sparse” kelimesi yanıltıcı olabilir: Bu yapı seyrek verilerden çok, $2$’nin kuvveti uzunluğundaki önceden hesaplanmış aralık bloklarından oluşur.
Devamı...
Sıralı verilerde arama yapmak istediğinizde bağlı listeler basit ama yavaştır; dengeli ikili arama ağaçları ise hızlı ama uygulaması görece karmaşıktır. Skip List, bu iki dünyanın arasına eğlenceli bir olasılık fikri yerleştirir: Bazı düğümlere rastgele seçilen ek “hız şeritleri” verir. Böylece listeyi tamamen yeniden dengelemeden, ortalama durumda oldukça hızlı arama, ekleme ve silme işlemleri sunar.
Devamı...
Dağıtık sistemlerde aynı veriyi birden fazla makinede tutmak harikadır; tek bir sunucu bozulduğunda sistem ayakta kalır. Fakat işin zor kısmı şudur: Ağ gecikebilir, makineler sessizce kapanabilir ve iki sunucu aynı anda farklı şeylerin doğru olduğuna inanabilir. Raft, bu kaosu yönetmek için tasarlanmış, anlaşılabilirliği önceleyen bir konsensüs algoritmasıdır. Temel hedefi, tüm sağlıklı düğümlerin işlemleri aynı sırayla uygulamasını sağlamaktır.
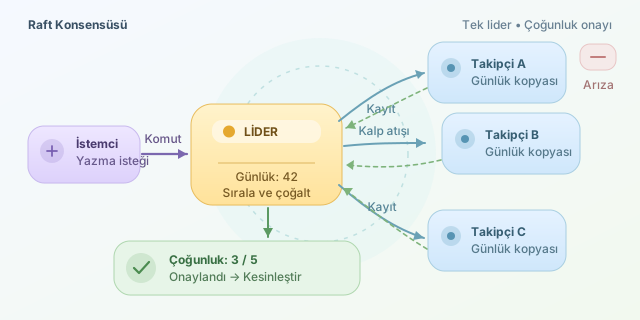
Devamı...
Dağıtık sistemlerde en zor soru çoğu zaman “veri nerede?” değil, “herkes aynı kararı verdi mi?” sorusudur. Ağ gecikebilir, makineler kapanabilir ve mesajlar kaybolabilir; buna rağmen banka bakiyesinin, lider seçiminin ya da sipariş durumunun tek bir doğru geçmişi olmalıdır. Paxos, düğümlerin çökebildiği bu kaotik ortamda ortak bir değerde uzlaşmayı sağlayan klasik consensus algoritmasıdır.
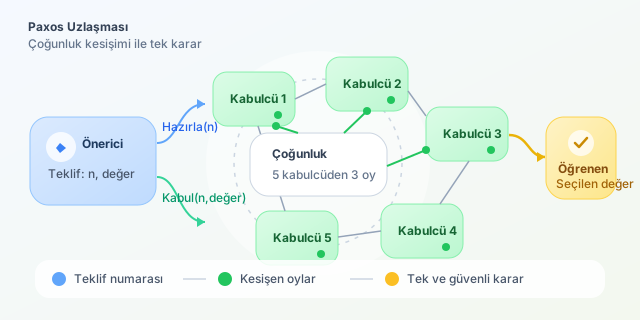
Devamı...
Bir dizideki çok sayıda aralık sorgusuna cevap vermek, ilk bakışta masum görünür: Her sorgu için ilgili aralığı dolaşır, sonucu hesaplar ve devam edersiniz. Ancak $N=Q=10^5$ olduğunda, her sorguyu tek tek taramak yaklaşık $O(NQ)$ maliyet üretir. İşte Mo Algoritması tam burada sahneye çıkar: Sorguları akıllıca yeniden sıralayarak, önceki sorgudan elde edilen bilgiyi mümkün olduğunca korur.
Devamı...