AutoML araçları, makine öğrenmesini “veriyi ver, sihri izle” düzeyine indirgeyen kutular değildir; iyi kullanıldıklarında veri hazırlama, özellik dönüşümü ve model arama süreçlerini sistematik biçimde hızlandırırlar. Ancak bir aracın gerçekten başarılı olup olmadığını anlamanın tek yolu, onu belirli bir veri setinde şeffaf ve tekrarlanabilir bir deneyle test etmektir. Buradaki amaç yalnızca en yüksek skoru bulmak değil, aracın hangi özellikleri faydalı gördüğünü ve hangi model ailesini neden seçtiğini değerlendirmektir.
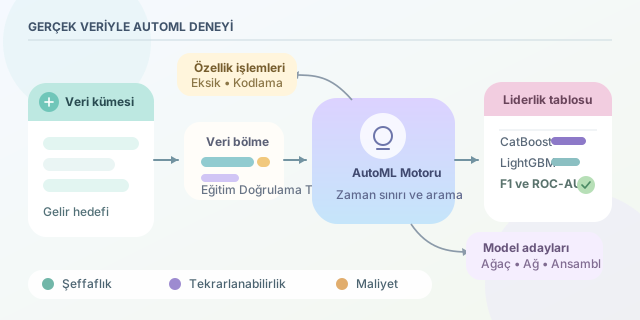
Devamı...
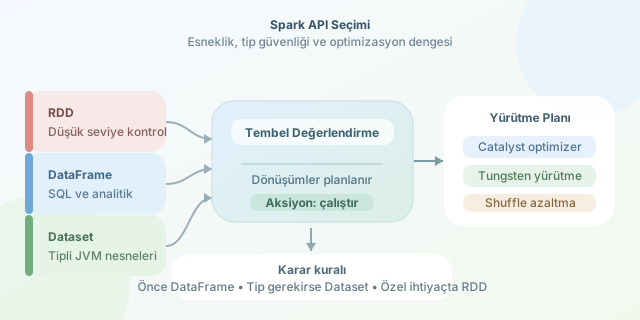
Apache Spark geliştiren herkesin karşısına aynı üçlü çıkar: RDD, DataFrame ve Dataset. Üçü de dağıtık veri işlemenin farklı yüzleridir; ancak soyutlama seviyesi yükseldikçe kod yazma deneyimi, tip güvenliği ve sorgu optimizasyonu da değişir. Doğru API seçimi yalnızca birkaç milisaniye kazanmak değildir: ekibin bakım maliyetini, hata ayıklama süresini ve küme kaynaklarının verimli kullanımını doğrudan etkiler.
Devamı...
Bir fabrikanın sıcaklık sensörlerini düşünün: cihazlar her 10 saniyede bir ölçüm üretir, ancak Wi-Fi kopmaları, mobil ağ gecikmeleri ve cihaz tamponları nedeniyle kayıtlar Flink’e kronolojik sırayla ulaşmaz. İşleme zamanına güvenmek, örneğin 10:00:05’te üretilen ama 10:00:40’ta gelen kritik bir sıcaklık artışını yanlış pencereye koyabilir. Apache Flink’in event-time yaklaşımı, olayın sisteme geliş anını değil, olayın gerçekten gerçekleştiği anı merkezine alır.
Devamı...
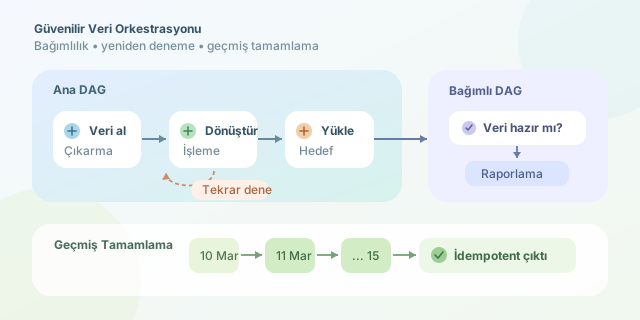
Veri boru hatları, tek seferlik çalışan betiklerden çok daha fazlasıdır: Her sabah veriyi çekmek, dönüştürmek, raporlamak ve olası aksaklıklarda sistemi güvenle toparlamak gerekir. Apache Airflow, bu süreci DAG (Directed Acyclic Graph — yönlü döngüsüz grafik) yaklaşımıyla yönetir. Her görev bir düğüm, görevler arasındaki sıralama ise bir yönlü kenardır. “Döngüsüz” olması önemlidir; A görevi B’yi, B de tekrar A’yı beklerse orkestrasyon sonsuza dek kahve molasına çıkar.
Devamı...
Bir kredi kartı işlemi, sunucu metriği veya üretim hattındaki sensör verisi normal davranıştan uzaklaştığında alarm vermek isteriz. Ancak etiketli “sahte” ya da “arıza” örnekleri çoğu zaman azdır. İşte bu noktada denetimsiz ve yarı denetimli anomali tespiti yöntemleri devreye girer. Isolation Forest (IF) ve One-Class SVM (OCSVM), aynı hedefe ulaşırken dünyayı oldukça farklı yorumlayan iki güçlü araçtır.
Devamı...
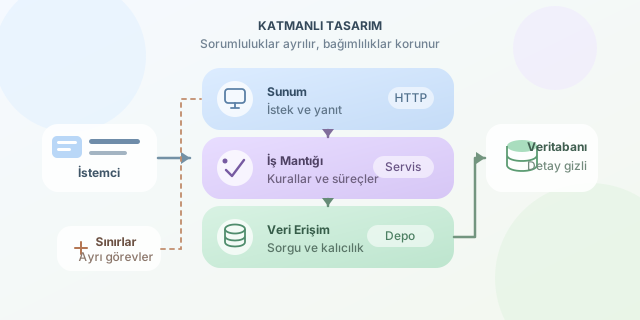
Katmanlı tasarım, büyük ve küçük ölçekli uygulamalarda kodun bir “spagetti tabağına” dönüşmesini engelleyen mimari yaklaşımlardan biridir. Temel fikir basittir: Kullanıcıyla konuşan kod, iş kurallarını uygulayan kod ve veriyi saklayan kod aynı sorumluluğu paylaşmamalıdır. Böylece bir veritabanı değişikliği ekranları, bir arayüz yenilemesi de kritik hesaplama kurallarını doğrudan etkilemez.
Devamı...
Veritabanı tasarımı, yalnızca tabloları yan yana dizmek değildir; verinin doğru, tutarlı ve hızlı erişilebilir kalmasını sağlayan bir mimari karar sürecidir. Normalizasyon tekrarları azaltarak veri bütünlüğünü korur, denormalizasyon ise bazı tekrarları bilinçli biçimde kabul ederek okuma performansını artırır. İyi tasarımcı, bu iki yaklaşımı rakip değil, farklı ihtiyaçlara hizmet eden araçlar olarak görür.
Devamı...
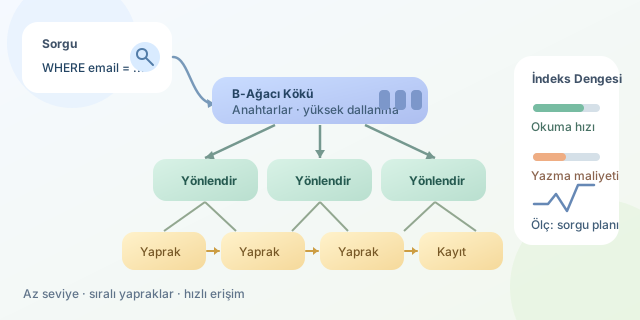
Bir veritabanı tablosunda milyonlarca kayıt varken WHERE email = '...' sorgusunun milisaniyeler içinde dönmesi sihir değildir; çoğu zaman arka planda çalışan bir B-ağacı indeksidir. İndeksler, kitabın sonundaki alfabetik dizin gibidir: Her sayfayı tek tek okumak yerine, aranan bilginin bulunduğu yere yönlendirir. Ancak her sütuna gelişigüzel indeks koymak da çözüm değildir; doğru indeks stratejisi, okuma performansı ile yazma maliyeti arasında dikkatli bir denge kurar.
Devamı...
Karmaşık bir veri kümesi, doğru görselleştirildiğinde onlarca sütun ve binlerce satır yerine birkaç saniyede kavranabilen bir hikâyeye dönüşür. Ancak grafikler yalnızca estetik araçlar değildir: eksen seçimi, renk, ölçek ve bağlam kararları okuyucunun sonucu nasıl yorumlayacağını doğrudan etkiler. İyi bir görselleştirme, veriyi “daha güzel” değil; daha doğru, daha erişilebilir ve daha sorgulanabilir hâle getirir.
Devamı...
Bir kütüphanenin yanında görünen v2.7.1 etiketi, yalnızca geliştiricilerin düzen takıntısını tatmin eden bir sayı dizisi değildir. Bu numara; güncellemenin güvenli olup olmadığını, mevcut kodun kırılma ihtimalini ve yeni yetenekler kazanıp kazanmayacağınızı anlatan küçük bir sözleşmedir. Semantik Versiyonlama ya da yaygın adıyla SemVer, bu sözleşmeyi herkesin aynı şekilde okuyabilmesini sağlar.
Devamı...
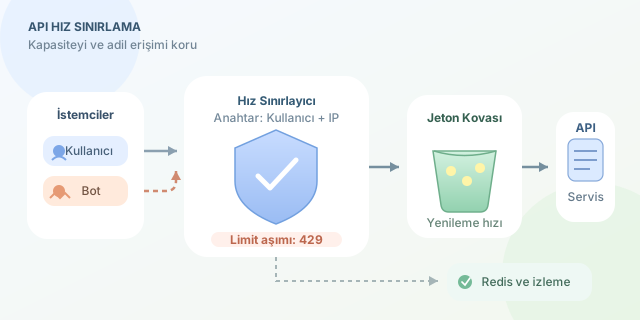
Bir API, internetin açık kapısı gibidir: doğru kullanıcılar için hızlı ve kullanışlı olmalı, fakat kapıyı saniyede binlerce kez çalan botlara da dayanmalıdır. Rate limiting (istek hız sınırlama), bir istemcinin belirli zaman aralığında yapabileceği istek sayısını kısıtlayarak servis kesintilerini, kaba kuvvet saldırılarını ve maliyet patlamalarını azaltır. Ancak tek başına “429 Too Many Requests” döndürmek sihirli bir kalkan değildir; doğru algoritma, doğru anahtar ve iyi gözlemlenebilirlik gerekir.
Devamı...
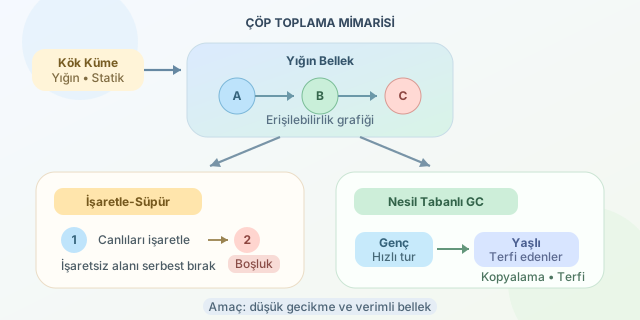
Modern programlama dillerinde belleği elle yönetmek, güçlü ama hata üretmeye açık bir sorumluluktur. Java, C#, Go, JavaScript ve birçok sanal makine tabanlı dil bu yükü çöp toplayıcıya (Garbage Collector, GC) devreder. GC’nin temel görevi basittir: Programın artık ulaşamadığı nesneleri bulmak ve alanlarını yeniden kullanılabilir hâle getirmek. Fakat bu basit cümle; gecikme, bellek tüketimi, CPU maliyeti ve uygulama akıcılığı arasında dikkatli tercihler gerektirir.
Devamı...
Uygulama geliştirirken nesnelerle çalışmak doğal gelir: User, Order ve Product gibi sınıflar tanımlar, davranışlarını metotlarda toplarız. Veritabanı ise daha farklı düşünür; satırlar, sütunlar, tablolar ve anahtarlarla konuşur. ORM (Object-Relational Mapping), bu iki dünyanın arasında çalışan tercümandır. Doğru kullanıldığında SQL tekrarını azaltır, veri erişimini okunur kılar ve geliştiricinin iş kurallarına odaklanmasına yardım eder.
Devamı...
Olimpiyat programlamada bir çözümün doğru cevap üretmesi yalnızca ilk adımdır; asıl soru, bunu verilen süre ve bellek içinde yapıp yapamayacağıdır. Aynı problemi kaba kuvvet, dinamik programlama, açgözlü yaklaşım veya gelişmiş veri yapılarıyla çözmek mümkün olabilir. Fakat yarışmada kazanan çözüm, test verisinin ölçeğine uygun karmaşıklık sınıfını seçen çözümdür. Bu nedenle kod yazmadan önce sınırları okumak, algoritma seçiminin pusulasıdır.
Devamı...
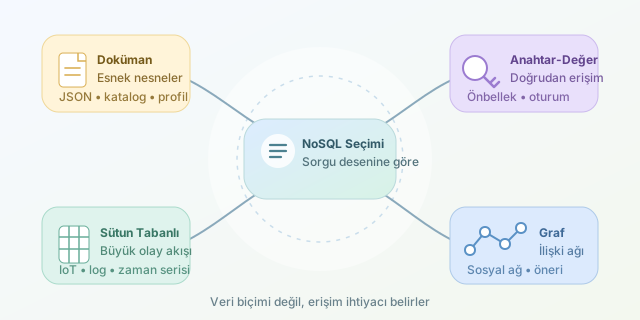
NoSQL, tek bir veritabanı teknolojisini değil; ilişkisel tablolara sığmayan veri modelleri için geliştirilmiş geniş bir yaklaşım ailesini ifade eder. Esnek şema, yatay ölçekleme ve yüksek erişilebilirlik ihtiyacı arttıkça doküman, anahtar-değer, sütun tabanlı ve graf veritabanları farklı problemlerde öne çıkar. Doğru seçimi yapmak için önce verinin nasıl sorgulanacağını anlamak gerekir: Veriniz nesne mi, olay akışı mı, devasa kayıt koleksiyonu mu, yoksa ilişkiler ağı mı?
Devamı...
Bir yazılım projesi büyümeye başladığında en kritik sorulardan biri şudur: Uygulamayı tek parça hâlinde mi tutmalı, yoksa küçük ve bağımsız servisler olarak mı bölmeliyiz? Monolitik ve mikroservis mimarileri, yalnızca kodun klasör yapısını değil; ekip organizasyonunu, dağıtım süreçlerini, maliyeti ve hata yönetimini de belirler. Bu nedenle doğru seçim, modaya değil projenin gerçek ihtiyaçlarına dayanmalıdır.
Devamı...
Açık kaynak dünyasında kod yazmak işin yalnızca yarısıdır; diğer yarısı ise insanların o kodla neler yapabileceğini belirlemektir. Bir lisans, projenizin kullanım, değiştirilme ve dağıtılma kurallarını tanımlayan hukuki bir sözleşmedir. MIT, GPL ve Apache 2.0 sıkça aynı sepete atılsa da ticari kullanım, kaynak kodun paylaşımı ve patent hakları konusunda oldukça farklı karakterlere sahiptir.
Devamı...
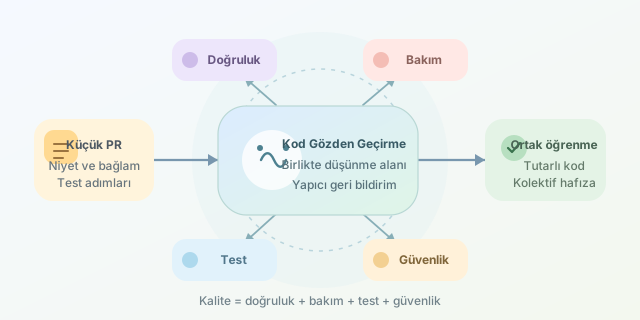
Kod gözden geçirme (code review), bir geliştiricinin yazdığı değişikliklerin başka ekip üyeleri tarafından incelenmesidir. Ancak bunu yalnızca “hata avı” olarak görmek büyük resmi kaçırmaktır. İyi kurulmuş bir inceleme kültürü; üretim hatalarını azaltır, mimari kararları görünür kılar, ekipteki bilgi adalarını yıkar ve herkesin daha tutarlı kod yazmasını sağlar. Kısacası pull request, kodun kapısını çalan bir denetçi değil; ekibin birlikte düşünme alanıdır.
Devamı...
Bir kullanıcı “Öde” düğmesine bastığında internet bağlantısı kopabilir, tarayıcı isteği yeniden gönderebilir veya mobil uygulama zaman aşımı nedeniyle otomatik tekrar deneyebilir. Sisteminiz ikinci isteği yeni bir ödeme gibi algılarsa, kullanıcı iki kez ücretlendirilir. Idempotency (yan etkisizlik), aynı işlemin birden fazla kez uygulanmasının sistemde ilk uygulamadan farklı bir sonuç üretmemesini hedefleyen tasarım ilkesidir. Kısacası: tekrarlar kaçınılmazdır; hasar olmak zorunda değildir.
Devamı...
Bir program yazdığınızda bilgisayar aslında if, while ya da print kelimelerinin ne anlama geldiğini doğrudan bilmez. İşlemcinin anlayabildiği şey, makine komutları olarak adlandırılan ikili talimatlardır. Kaynak kod ile işlemci arasındaki tercümanlık görevini ise iki temel yaklaşım üstlenir: derleme (compilation) ve yorumlama (interpretation). Bu fark yalnızca programın ne kadar hızlı açıldığını değil; hata ayıklama, dağıtım, taşınabilirlik ve güvenlik tercihlerini de etkiler.
Devamı...