Kubernetes kümesinde trafik bazen sakin bir mahalle, bazen de indirim gününde açılmış bir mağaza gibidir. Horizontal Pod Autoscaler (HPA), bu dalgalanmayı izleyip uygulamanın pod sayısını otomatik artırır veya azaltır. Ancak HPA bir “CPU yükseldi, pod ekle” düğmesi değildir; metrikleri hedeflerle karşılaştıran, oran hesaplayan ve kararsızlığı önleyen kontrollü bir karar mekanizmasıdır. Bu mekanizmayı anlamak, hem gereksiz maliyetleri hem de yoğun saatlerde yaşanan gecikmeleri azaltmanın anahtarıdır.
Devamı...
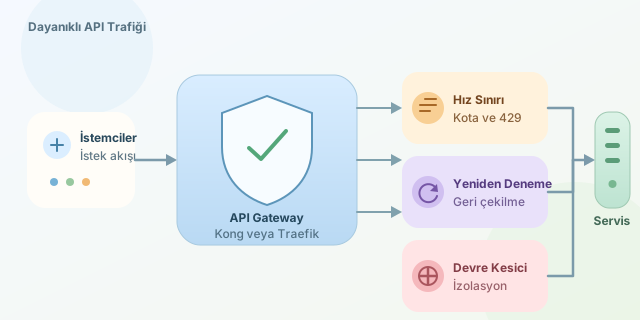
Modern mikroservis mimarisinde API Gateway yalnızca istekleri doğru servise yönlendiren bir trafik polisi değildir; aynı zamanda sistemin kapısındaki güvenlik görevlisi, tamponu ve kriz yöneticisidir. Kong ve Traefik gibi gateway’ler üzerinden rate limiting, circuit breaker ve retry politikaları tanımlamak; ani trafik patlamalarının, geçici ağ hatalarının ve domino etkisi yaratan servis arızalarının tüm platformu devirmesini engeller.
Devamı...
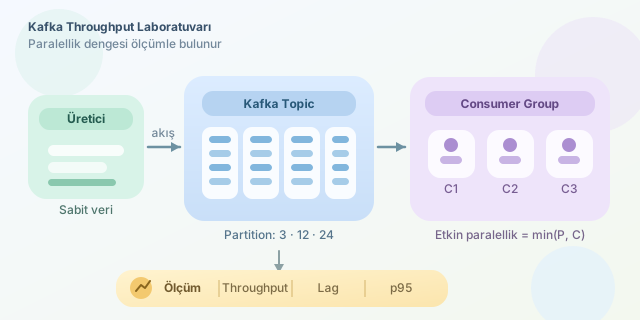
Apache Kafka’da yüksek iş hacmi yalnızca daha güçlü sunucular eklemekle elde edilmez; partition sayısı, consumer group içindeki tüketici sayısı, mesaj boyutu ve disk-ağ kapasitesi birlikte çalışır. En iyi yapılandırma, tahminle değil ölçümle bulunur. Bu yazıda kontrollü deneyler kurarak partition ve consumer group kararlarının üretim (produce) ve tüketim (consume) throughput’unu nasıl değiştirdiğini inceleyeceğiz.
Devamı...
JWT tabanlı kimlik doğrulama, stateless yapısı sayesinde ölçeklenebilir uygulamalarda oldukça popülerdir; ancak token çalınması, uzun oturumlar ve cihaz yönetimi gibi konular dikkatli tasarlanmadığında ciddi güvenlik açıkları doğurur. Bu noktada kısa ömürlü access token ve rotasyona tabi refresh token ikilisi, hem kullanıcı deneyimini hem de güvenlik seviyesini dengeler.
Devamı...
Mikroservis mimarisinde bir isteğin kaç farklı servisten geçtiğini takip etmek bile bazen dedektiflik gerektirir. Güvenlik açısından daha kritik soru ise şudur: Bu servisler gerçekten birbirleriyle konuştuğunu sandıkları servisler mi? Servis ağı (service mesh), uygulama kodunu güvenlik ve ağ politikalarıyla şişirmeden bu sorunu çözmek için tasarlanır. Istio ve Linkerd; şifreleme, kimlik doğrulama, yetkilendirme, gözlemlenebilirlik ve trafik yönetimini altyapı katmanına taşır.
Devamı...
Modern servisler yalnızca istek alıp JSON döndüren yapılardan ibaret değil: canlı konum, borsa verisi, oyun olayları ve telemetri akışları sürekli iletişim bekliyor. Bu noktada gRPC’nin HTTP/2 üzerinde çalışan streaming modeli, REST’in klasik istek-cevap ritmine güçlü bir alternatif sunar. Ancak “gRPC her zaman hızlıdır” demek yerine; gecikme, mesaj boyutu, eşzamanlı bağlantı ve iş yükü türü üzerinden ölçüm yapmak gerekir.
Devamı...
GraphQL, istemciye ihtiyacı olan veriyi seçme özgürlüğü verir; fakat bu esneklik resolver katmanında gizli bir maliyet doğurabilir. Kullanıcıları ve her kullanıcının gönderilerini listeleyen basit bir sorgu düşünün: kullanıcılar için bir sorgu, ardından her kullanıcı için ayrı gönderi sorgusu çalışır. Veri tabanı açısından masum görünen bu akış, kullanıcı sayısı arttıkça bir sorgu fırtınasına dönüşür. İşte bu klasik N+1 problemidir.
Devamı...
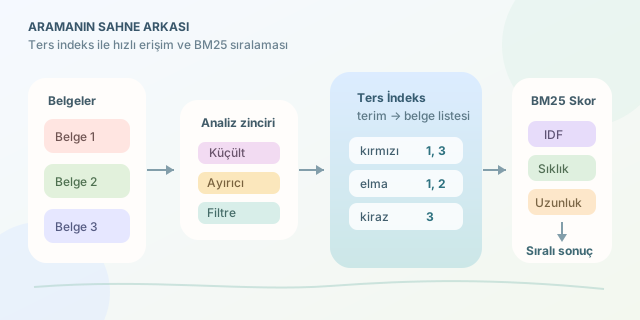
Elasticsearch, milyonlarca belge arasında milisaniyeler içinde arama yapabilmesini büyük ölçüde ters indeks (inverted index) adlı yapıya borçludur. Klasik bir veritabanında “bu belgenin içinde hangi kelimeler var?” sorusu öne çıkarken, ters indeks “bu kelime hangi belgelerde geçiyor?” sorusunu merkeze alır. Arama motoru dünyasının sihirbaz şapkası tam olarak budur.
Devamı...
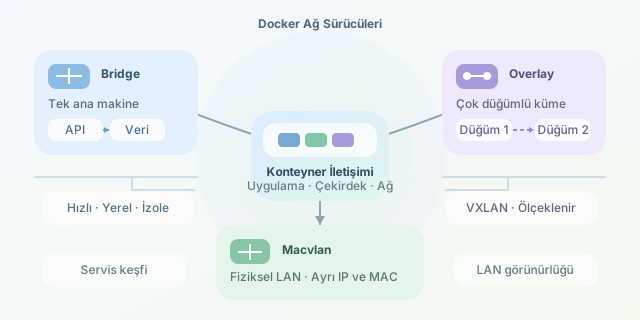
Docker’da ağ sürücüsü seçmek, sadece konteynerlere IP dağıtmak değildir; erişim sınırlarını, servis keşfini, gecikmeyi ve altyapının ölçeklenme biçimini belirler. Aynı uygulamanın yerel bir makinede, çok düğümlü bir kümede veya fiziksel ağda görünür olması gerektiğinde farklı sürücüler anlam kazanır. Bu yazıda bridge, overlay ve macvlan sürücülerini küçük ama tekrarlanabilir deneylerle karşılaştıralım.
Devamı...
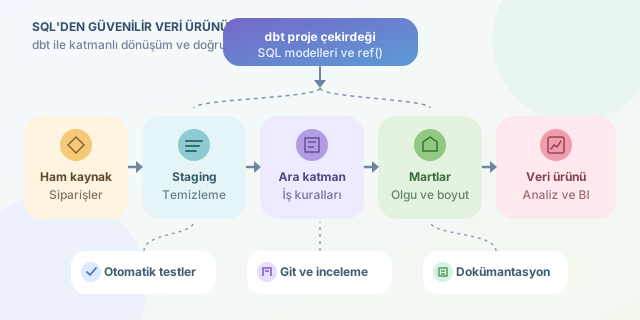
Modern veri ekiplerinde asıl zorluk, veriyi depoya taşımaktan çok onu güvenilir, anlaşılır ve yeniden üretilebilir biçimde dönüştürmektir. dbt (data build tool), bu problemi SQL dönüşümlerini yazılım geliştirme disiplinleriyle birleştirerek çözer. Böylece karmaşık ETL betikleri yerine Git ile izlenen modeller, testler, dokümantasyon ve bağımlılık grafikleriyle yönetilen bir veri platformu elde edersiniz.
Devamı...
AutoML araçları, makine öğrenmesini “veriyi ver, sihri izle” düzeyine indirgeyen kutular değildir; iyi kullanıldıklarında veri hazırlama, özellik dönüşümü ve model arama süreçlerini sistematik biçimde hızlandırırlar. Ancak bir aracın gerçekten başarılı olup olmadığını anlamanın tek yolu, onu belirli bir veri setinde şeffaf ve tekrarlanabilir bir deneyle test etmektir. Buradaki amaç yalnızca en yüksek skoru bulmak değil, aracın hangi özellikleri faydalı gördüğünü ve hangi model ailesini neden seçtiğini değerlendirmektir.
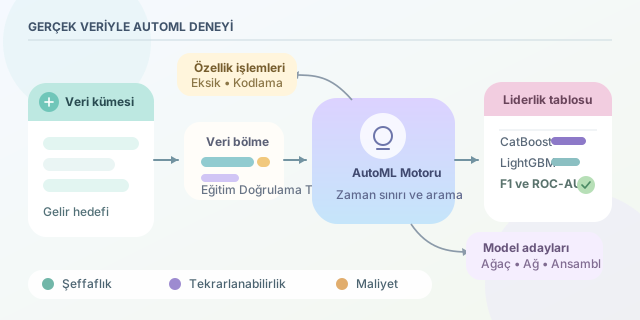
Devamı...
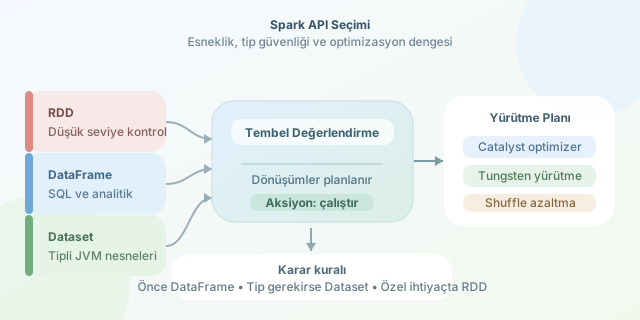
Apache Spark geliştiren herkesin karşısına aynı üçlü çıkar: RDD, DataFrame ve Dataset. Üçü de dağıtık veri işlemenin farklı yüzleridir; ancak soyutlama seviyesi yükseldikçe kod yazma deneyimi, tip güvenliği ve sorgu optimizasyonu da değişir. Doğru API seçimi yalnızca birkaç milisaniye kazanmak değildir: ekibin bakım maliyetini, hata ayıklama süresini ve küme kaynaklarının verimli kullanımını doğrudan etkiler.
Devamı...
Bir fabrikanın sıcaklık sensörlerini düşünün: cihazlar her 10 saniyede bir ölçüm üretir, ancak Wi-Fi kopmaları, mobil ağ gecikmeleri ve cihaz tamponları nedeniyle kayıtlar Flink’e kronolojik sırayla ulaşmaz. İşleme zamanına güvenmek, örneğin 10:00:05’te üretilen ama 10:00:40’ta gelen kritik bir sıcaklık artışını yanlış pencereye koyabilir. Apache Flink’in event-time yaklaşımı, olayın sisteme geliş anını değil, olayın gerçekten gerçekleştiği anı merkezine alır.
Devamı...
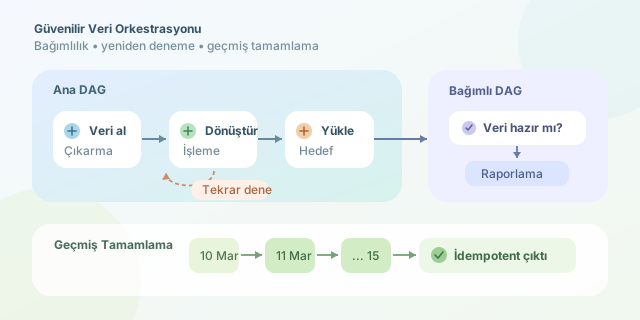
Veri boru hatları, tek seferlik çalışan betiklerden çok daha fazlasıdır: Her sabah veriyi çekmek, dönüştürmek, raporlamak ve olası aksaklıklarda sistemi güvenle toparlamak gerekir. Apache Airflow, bu süreci DAG (Directed Acyclic Graph — yönlü döngüsüz grafik) yaklaşımıyla yönetir. Her görev bir düğüm, görevler arasındaki sıralama ise bir yönlü kenardır. “Döngüsüz” olması önemlidir; A görevi B’yi, B de tekrar A’yı beklerse orkestrasyon sonsuza dek kahve molasına çıkar.
Devamı...
Bir kredi kartı işlemi, sunucu metriği veya üretim hattındaki sensör verisi normal davranıştan uzaklaştığında alarm vermek isteriz. Ancak etiketli “sahte” ya da “arıza” örnekleri çoğu zaman azdır. İşte bu noktada denetimsiz ve yarı denetimli anomali tespiti yöntemleri devreye girer. Isolation Forest (IF) ve One-Class SVM (OCSVM), aynı hedefe ulaşırken dünyayı oldukça farklı yorumlayan iki güçlü araçtır.
Devamı...
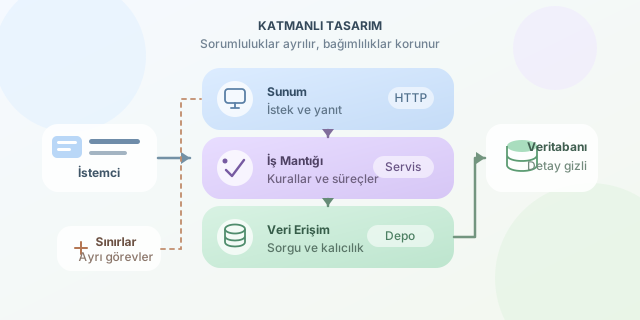
Katmanlı tasarım, büyük ve küçük ölçekli uygulamalarda kodun bir “spagetti tabağına” dönüşmesini engelleyen mimari yaklaşımlardan biridir. Temel fikir basittir: Kullanıcıyla konuşan kod, iş kurallarını uygulayan kod ve veriyi saklayan kod aynı sorumluluğu paylaşmamalıdır. Böylece bir veritabanı değişikliği ekranları, bir arayüz yenilemesi de kritik hesaplama kurallarını doğrudan etkilemez.
Devamı...
Veritabanı tasarımı, yalnızca tabloları yan yana dizmek değildir; verinin doğru, tutarlı ve hızlı erişilebilir kalmasını sağlayan bir mimari karar sürecidir. Normalizasyon tekrarları azaltarak veri bütünlüğünü korur, denormalizasyon ise bazı tekrarları bilinçli biçimde kabul ederek okuma performansını artırır. İyi tasarımcı, bu iki yaklaşımı rakip değil, farklı ihtiyaçlara hizmet eden araçlar olarak görür.
Devamı...
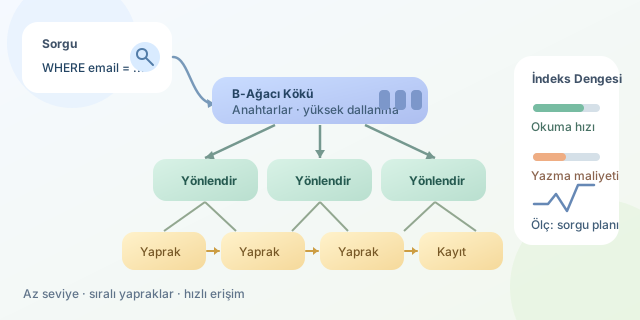
Bir veritabanı tablosunda milyonlarca kayıt varken WHERE email = '...' sorgusunun milisaniyeler içinde dönmesi sihir değildir; çoğu zaman arka planda çalışan bir B-ağacı indeksidir. İndeksler, kitabın sonundaki alfabetik dizin gibidir: Her sayfayı tek tek okumak yerine, aranan bilginin bulunduğu yere yönlendirir. Ancak her sütuna gelişigüzel indeks koymak da çözüm değildir; doğru indeks stratejisi, okuma performansı ile yazma maliyeti arasında dikkatli bir denge kurar.
Devamı...
Karmaşık bir veri kümesi, doğru görselleştirildiğinde onlarca sütun ve binlerce satır yerine birkaç saniyede kavranabilen bir hikâyeye dönüşür. Ancak grafikler yalnızca estetik araçlar değildir: eksen seçimi, renk, ölçek ve bağlam kararları okuyucunun sonucu nasıl yorumlayacağını doğrudan etkiler. İyi bir görselleştirme, veriyi “daha güzel” değil; daha doğru, daha erişilebilir ve daha sorgulanabilir hâle getirir.
Devamı...
Bir kütüphanenin yanında görünen v2.7.1 etiketi, yalnızca geliştiricilerin düzen takıntısını tatmin eden bir sayı dizisi değildir. Bu numara; güncellemenin güvenli olup olmadığını, mevcut kodun kırılma ihtimalini ve yeni yetenekler kazanıp kazanmayacağınızı anlatan küçük bir sözleşmedir. Semantik Versiyonlama ya da yaygın adıyla SemVer, bu sözleşmeyi herkesin aynı şekilde okuyabilmesini sağlar.
Devamı...