Bir uygulamayı Android, iOS, web ve masaüstünde çalıştırmak eskiden ayrı ekipler, ayrı kod tabanları ve bolca senkronizasyon toplantısı anlamına gelirdi. Flutter bu tabloyu değiştirmeyi hedefler: Dart ile yazılan tek bir arayüz kodu, farklı platformlarda yerel hissi veren deneyimlere dönüşür. Üstelik mesele yalnızca “bir kere yaz, her yerde çalıştır” değildir; Flutter’ın güçlü çizim altyapısı sayesinde geçişler, mikro etkileşimler ve karmaşık animasyonlar da tutarlı biçimde üretilebilir.
Devamı...
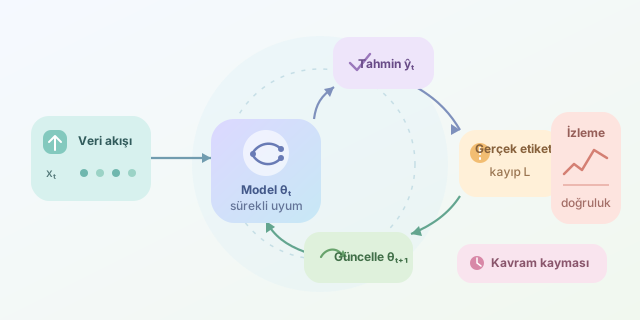
Bir makine öğrenmesi modelini bir kez eğitip sonsuza dek görev başında bırakmak, dünün hava durumuyla bugün şemsiye seçmeye benzer. Gerçek dünyadaki veriler; kullanıcı tercihleri, dolandırıcılık yöntemleri, sensör ölçümleri ve piyasa davranışlarıyla birlikte sürekli değişir. Çevrimiçi öğrenme (online learning), modelin tüm geçmiş veriyi yeniden işlemeye ihtiyaç duymadan yeni gözlemler geldikçe kendini küçük adımlarla güncellemesini sağlar.
Devamı...
Bir oyunun tüm kurallarını C++ ile derlemek hızlıdır; ancak zıplama yüksekliği, düşman davranışı veya görev ödülleri için her değişiklikte motoru yeniden derlemek üretim hızını düşürür. Lua, hafif çalışma zamanı ve sade sözdizimiyle bu sorunu çözer: performans kritik çekirdek C++ içinde kalırken, tasarımcıların sık değiştirdiği oyun mantığı betiklere taşınır.
Devamı...
Etiketli veri, makine öğrenmesinin kahvesidir: model onsuz güne başlayamaz. Fakat gerçek hayatta her örneği uzmanlara etiketletmek pahalı, yavaş ve bazen de oldukça sıkıcıdır. Aktif öğrenme (active learning), elinizde küçük bir etiketli küme ve büyük bir etiketsiz havuz varken modele söz hakkı verir: Model, öğrenmesine en fazla katkıyı sağlayacak örneklerin etiketini ister. Ama kritik soru şudur: Modelin hangi örnekleri sormasına izin vermeliyiz?
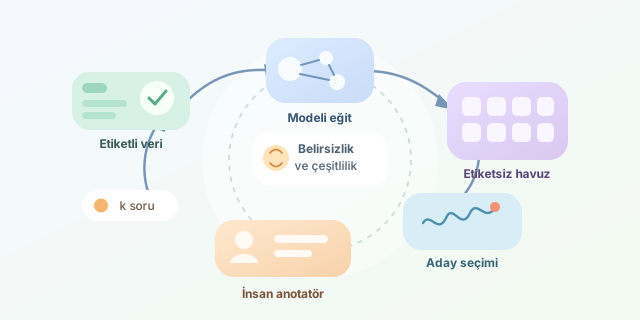
Devamı...
Bir bilgisayarın açılışında işletim sistemi henüz sahnede değildir: ekran kartına görüntü çizdirecek sürücüler, dosya sistemi ve hatta bellek yöneticisi yoktur. Buna rağmen işlemci birkaç talimat çalıştırarak makineyi hayata döndürür. Bootloader yazmak, bu minimal ortamda BIOS, disk ve CPU ile doğrudan konuşmayı öğrenmektir. Küçücük bir 512 baytlık programla ekrana mesaj basmak, donanım ile işletim sistemi arasındaki köprünün ilk tahtasını yerleştirmek gibidir.
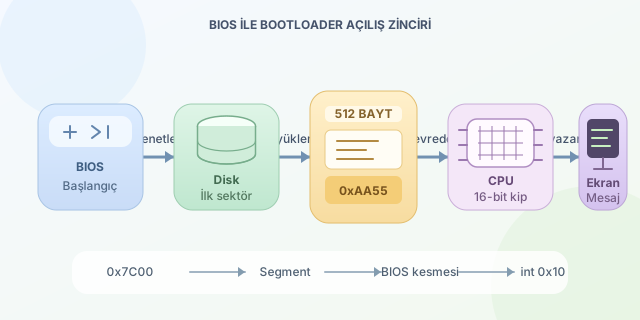
Devamı...
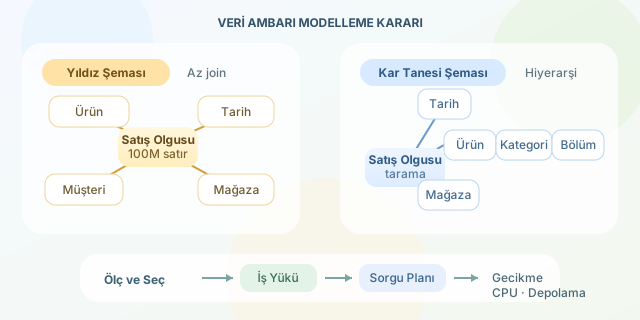
Veri ambarı tasarımında en tartışmalı kararlardan biri, boyut tablolarını sade bırakıp yıldız şeması kullanmak mı, yoksa onları alt tablolara ayırıp kar tanesi şeması ile normalize etmek mi sorusudur. Bu tercih yalnızca diyagramın estetiğini değil; disk tüketimini, ETL akışını, sorgu planını ve analistlerin bekleme süresini doğrudan etkiler. Sağlıklı bir karar için sezgilere değil, temsilî iş yüküyle yapılan modelleme çalışmasına ihtiyaç vardır.
Devamı...
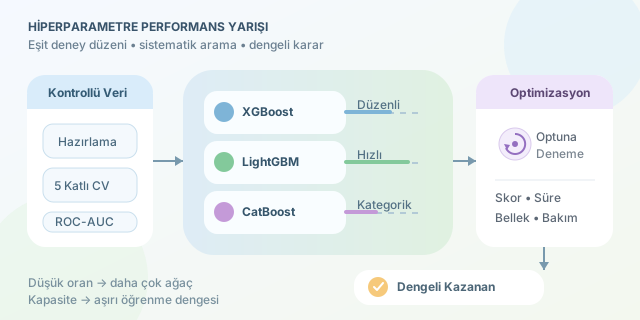
Gradient boosting ailesi, tabular verilerdeki güçlü performansıyla veri biliminin Formula 1 aracı gibidir: doğru ayarlarla inanılmaz hızlıdır, yanlış ayarla ise duvara çarpması kolaydır. XGBoost, LightGBM ve CatBoost aynı temel fikri paylaşsa da ağaçları büyütme stratejileri, kategorik veriye yaklaşımları ve düzenlileştirme seçenekleri farklıdır. Bu nedenle adil bir karşılaştırma, varsayılan parametrelerle değil; kontrollü veri hazırlama, çapraz doğrulama ve sistematik hiperparametre optimizasyonu ile yapılmalıdır.
Devamı...
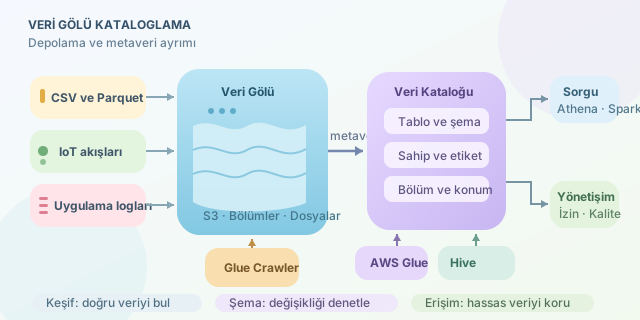
Veri gölü, ham CSV dosyalarından IoT akışlarına, Parquet tablolarından uygulama loglarına kadar farklı kaynakları düşük maliyetle saklar. Fakat klasörler büyüdükçe klasik “dosya nerede?” yaklaşımı hızla yetersiz kalır. Veri kataloglama; dosyaların fiziksel konumunu, şemasını, sahipliğini, etiketlerini ve kullanım kurallarını merkezi bir envantere dönüştürür. Böylece analistler doğru veriyi bulur, veri mühendisleri aynı tabloyu tekrar üretmez, yönetişim ekipleri ise erişimi denetlenebilir biçimde yönetir.
Devamı...
Bulut altyapısını elle yönetmek, ilk birkaç sunucuda masum görünür; fakat dev, test ve prod ortamları çoğaldıkça aynı güvenlik grubu, ağ ve veritabanı ayarlarını kopyalamak hızla bir bakım kabusuna dönüşür. Terraform modülleri bu sorunu, altyapı bileşenlerini parametre alan küçük ve tekrar kullanılabilir paketlere dönüştürerek çözer. Böylece ekipler aynı mimari standardı her ortamda korurken, yalnızca ortama özgü değerleri değiştirir.
Devamı...
Tek bir makine öğrenmesi modeli her zaman yıldız oyuncu olmayabilir; bazen farklı yeteneklere sahip modelleri aynı takımda oynatmak daha iyi sonuç verir. Süper öğrenme ya da yaygın adıyla stacking, birden fazla temel modelin tahminlerini yeni bir modelin girdisi haline getirir. Amaç, modellerin güçlü yanlarını birleştirirken birbirlerinin hatalarını dengelemektir. Örneğin doğrusal bir model genel eğilimi yakalarken, ağaç tabanlı bir model karmaşık ve doğrusal olmayan ilişkileri keşfedebilir.
Devamı...
Bir kullanıcıya yeni sipariş, mesaj, fiyat değişimi veya sistem alarmı ulaştırmak istediğinizde klasik HTTP istek-cevap modeli yetersiz kalır. Tarayıcının sürekli “Yeni bir şey var mı?” diye sorması hem gecikme hem de gereksiz sunucu yükü üretir. SSE (Server-Sent Events) ve WebSocket, sunucu ile istemci arasındaki bağlantıyı canlı tutarak bu sorunu çözer; fakat aynı probleme farklı yönlerden yaklaşırlar.
Devamı...
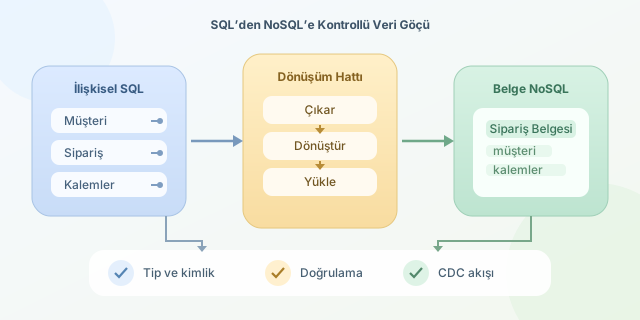
SQL ve NoSQL arasında veri göçü, yalnızca bir tablodan diğerine kayıt kopyalamak değildir; veri modelinin dünyayı yorumlama biçimini değiştirmektir. İlişkisel sistemler tutarlılığı tablolar, anahtarlar ve kısıtlarla korurken; NoSQL sistemleri ölçeklenebilirlik, esnek şema ve erişim desenlerini öne çıkarır. Bu nedenle başarılı bir göçün temel sorusu “Veriyi nasıl taşırım?” değil, “Uygulama bu veriyi hangi sorgularla kullanacak?” olmalıdır.
Devamı...
Veri sıkıştırma, disk alanını azaltmaktan çok daha fazlasıdır: ağ maliyeti, önbellek verimliliği, yedekleme süresi ve işlemci tüketimi arasında yapılan bir pazarlıktır. Snappy, Zstd ve Gzip bu pazarlığın üç farklı karakteridir. Snappy mümkün olan en düşük gecikmeye odaklanır, Gzip köklü ve yaygın uyumluluğu temsil eder, Zstd ise modern donanımlarda hem yüksek hız hem de güçlü oran hedefler. Sağlıklı bir seçim için ezbere değil, temsilî verinizle ölçüme ihtiyaç vardır.
Devamı...
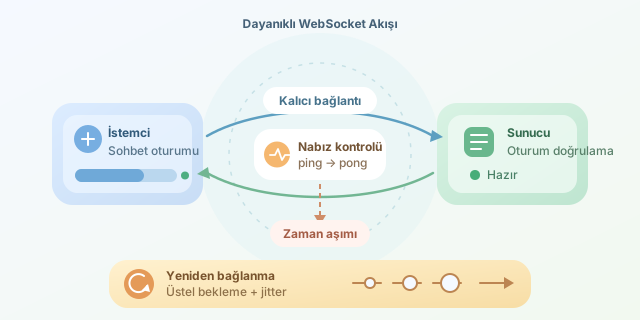
Gerçek zamanlı sohbet uygulamalarında kullanıcılar bağlantının her zaman açık kalmasını bekler. Ancak mobil ağ değişimleri, tarayıcının uykuya geçmesi, sunucu yeniden başlatmaları ve geçici paket kayıpları bu beklentiyi kolayca bozar. Sağlam bir WebSocket istemcisi, kopmayı bir hata sonu değil, yönetilmesi gereken normal bir durum olarak görür. Bu noktada iki temel araç devreye girer: yeniden bağlanma (reconnection) ve heartbeat, yani nabız kontrolü.
Devamı...
Mikroservis mimarisinde bir siparişin oluşturulması, ödemenin alınması ve stok rezervasyonu tek bir veritabanı işlemi değildir; her servis kendi verisine sahiptir. Klasik ACID transaction yaklaşımını servisler arasında yaymak hem pahalı hem de kırılgandır. Saga deseni, büyük işlemi yerel işlemlere böler ve bir adım başarısız olduğunda önceki adımları geri almak için telafi edici işlemler (compensating transactions) çalıştırır. Böylece sistem, anlık tutarlılık yerine kontrollü bir eventual consistency modeli benimser.
Devamı...
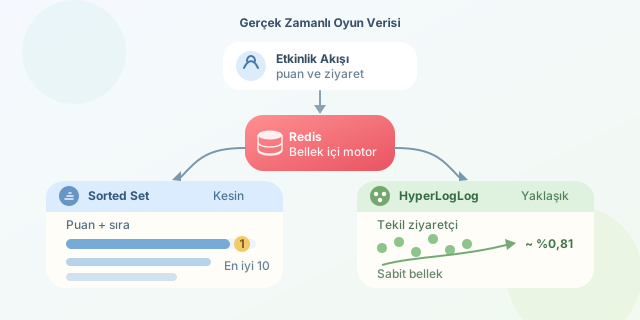
Bir oyun uygulamasında en iyi oyuncuları saniyeler içinde sıralamak ya da bir kampanyayı kaç farklı kullanıcının gördüğünü hesaplamak, ilk bakışta basit görünür. Ancak trafik arttığında klasik SQL sorguları, sürekli güncellenen sayaçlar ve büyük DISTINCT işlemleri pahalılaşır. Redis; bellekte çalışan, düşük gecikmeli veri yapıları sayesinde bu iki problemi zarif biçimde çözer: lider tabloları için Sorted Set, yaklaşık tekil sayım için ise HyperLogLog.
Devamı...
Dağıtık sistemlerde bir mesajın tüketiciye ulaşması, başarıyla işlendiği anlamına gelmez. Veritabanı geçici olarak kapalı olabilir, üçüncü taraf API’si hata verebilir ya da mesajın verisi gerçekten bozuk olabilir. RabbitMQ’nun Dead Letter Exchange (DLX) ve gecikmeli yeniden deneme kurgusu, bu durumlarda mesajları kaybetmeden kontrollü biçimde yönetmeyi sağlar. Amaç, aynı hatalı mesajı sonsuza kadar ana kuyruğu kilitleyecek şekilde tüketmek değil; geçici hatalara zaman tanımak, kalıcı hataları ise görünür ve incelenebilir hale getirmektir.
Devamı...
Büyük veri sistemlerinde dosya formatı seçimi, yalnızca depolama maliyetini değil; Spark, Hive, Trino veya Presto gibi araçlardaki sorgu süresini de doğrudan belirler. Parquet ve ORC, satır bazlı CSV ya da JSON yerine sütun bazlı veri saklayarak analitik iş yüklerini hızlandıran iki güçlü formattır. Ancak benzer hedeflere sahip olsalar da metadata organizasyonları, sıkıştırma stratejileri ve ekosistem uyumları farklıdır.
Devamı...
MongoDB, büyüyen uygulamalarda yalnızca daha fazla veri saklama problemiyle değil, aynı anda gelen binlerce isteği güvenle işleme problemiyle de karşılaşır. Bu noktada replication, sistemin ayakta kalmasını sağlayan güvenlik ağıdır; sharding ise veriyi ve yazma yükünü birden fazla makineye dağıtan ölçekleme motorudur. İkisini birlikte doğru tasarlamak, hem kesintilere dayanıklı hem de yüksek yazma kapasiteli bir mimari oluşturur.
Devamı...
Mikroservis mimarisinde tek bir kullanıcı isteği, çoğu zaman API Gateway’den başlayıp kimlik doğrulama, katalog, ödeme, stok ve bildirim servisleri arasında dolaşır. Bir sayfanın üç saniyede açılması can sıkıcıdır; fakat asıl zor soru şudur: Bu üç saniyeyi hangi servis, hangi veritabanı sorgusu veya hangi ağ çağrısı tüketti? Distributed tracing, isteğin yolculuğunu uçtan uca görünür hâle getirerek tahmin oyununu ölçülebilir bir performans araştırmasına dönüştürür.
Devamı...