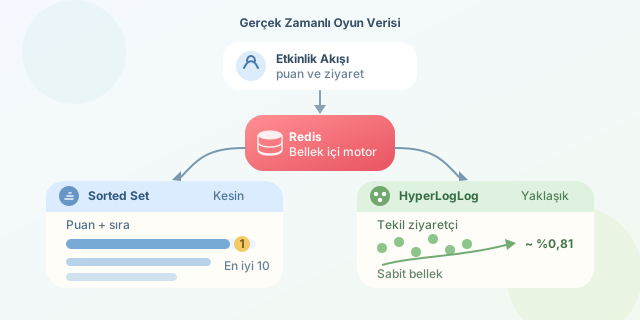
Bir oyun uygulamasında en iyi oyuncuları saniyeler içinde sıralamak ya da bir kampanyayı kaç farklı kullanıcının gördüğünü hesaplamak, ilk bakışta basit görünür. Ancak trafik arttığında klasik SQL sorguları, sürekli güncellenen sayaçlar ve büyük DISTINCT işlemleri pahalılaşır. Redis; bellekte çalışan, düşük gecikmeli veri yapıları sayesinde bu iki problemi zarif biçimde çözer: lider tabloları için Sorted Set, yaklaşık tekil sayım için ise HyperLogLog.
Devamı...
Dağıtık sistemlerde bir mesajın tüketiciye ulaşması, başarıyla işlendiği anlamına gelmez. Veritabanı geçici olarak kapalı olabilir, üçüncü taraf API’si hata verebilir ya da mesajın verisi gerçekten bozuk olabilir. RabbitMQ’nun Dead Letter Exchange (DLX) ve gecikmeli yeniden deneme kurgusu, bu durumlarda mesajları kaybetmeden kontrollü biçimde yönetmeyi sağlar. Amaç, aynı hatalı mesajı sonsuza kadar ana kuyruğu kilitleyecek şekilde tüketmek değil; geçici hatalara zaman tanımak, kalıcı hataları ise görünür ve incelenebilir hale getirmektir.
Devamı...
Büyük veri sistemlerinde dosya formatı seçimi, yalnızca depolama maliyetini değil; Spark, Hive, Trino veya Presto gibi araçlardaki sorgu süresini de doğrudan belirler. Parquet ve ORC, satır bazlı CSV ya da JSON yerine sütun bazlı veri saklayarak analitik iş yüklerini hızlandıran iki güçlü formattır. Ancak benzer hedeflere sahip olsalar da metadata organizasyonları, sıkıştırma stratejileri ve ekosistem uyumları farklıdır.
Devamı...
MongoDB, büyüyen uygulamalarda yalnızca daha fazla veri saklama problemiyle değil, aynı anda gelen binlerce isteği güvenle işleme problemiyle de karşılaşır. Bu noktada replication, sistemin ayakta kalmasını sağlayan güvenlik ağıdır; sharding ise veriyi ve yazma yükünü birden fazla makineye dağıtan ölçekleme motorudur. İkisini birlikte doğru tasarlamak, hem kesintilere dayanıklı hem de yüksek yazma kapasiteli bir mimari oluşturur.
Devamı...
Mikroservis mimarisinde tek bir kullanıcı isteği, çoğu zaman API Gateway’den başlayıp kimlik doğrulama, katalog, ödeme, stok ve bildirim servisleri arasında dolaşır. Bir sayfanın üç saniyede açılması can sıkıcıdır; fakat asıl zor soru şudur: Bu üç saniyeyi hangi servis, hangi veritabanı sorgusu veya hangi ağ çağrısı tüketti? Distributed tracing, isteğin yolculuğunu uçtan uca görünür hâle getirerek tahmin oyununu ölçülebilir bir performans araştırmasına dönüştürür.
Devamı...
Kubernetes kümesinde trafik bazen sakin bir mahalle, bazen de indirim gününde açılmış bir mağaza gibidir. Horizontal Pod Autoscaler (HPA), bu dalgalanmayı izleyip uygulamanın pod sayısını otomatik artırır veya azaltır. Ancak HPA bir “CPU yükseldi, pod ekle” düğmesi değildir; metrikleri hedeflerle karşılaştıran, oran hesaplayan ve kararsızlığı önleyen kontrollü bir karar mekanizmasıdır. Bu mekanizmayı anlamak, hem gereksiz maliyetleri hem de yoğun saatlerde yaşanan gecikmeleri azaltmanın anahtarıdır.
Devamı...
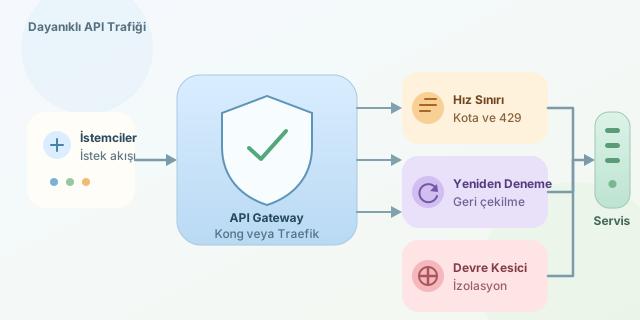
Modern mikroservis mimarisinde API Gateway yalnızca istekleri doğru servise yönlendiren bir trafik polisi değildir; aynı zamanda sistemin kapısındaki güvenlik görevlisi, tamponu ve kriz yöneticisidir. Kong ve Traefik gibi gateway’ler üzerinden rate limiting, circuit breaker ve retry politikaları tanımlamak; ani trafik patlamalarının, geçici ağ hatalarının ve domino etkisi yaratan servis arızalarının tüm platformu devirmesini engeller.
Devamı...
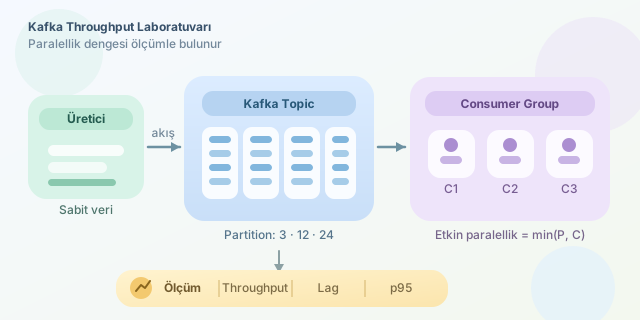
Apache Kafka’da yüksek iş hacmi yalnızca daha güçlü sunucular eklemekle elde edilmez; partition sayısı, consumer group içindeki tüketici sayısı, mesaj boyutu ve disk-ağ kapasitesi birlikte çalışır. En iyi yapılandırma, tahminle değil ölçümle bulunur. Bu yazıda kontrollü deneyler kurarak partition ve consumer group kararlarının üretim (produce) ve tüketim (consume) throughput’unu nasıl değiştirdiğini inceleyeceğiz.
Devamı...
JWT tabanlı kimlik doğrulama, stateless yapısı sayesinde ölçeklenebilir uygulamalarda oldukça popülerdir; ancak token çalınması, uzun oturumlar ve cihaz yönetimi gibi konular dikkatli tasarlanmadığında ciddi güvenlik açıkları doğurur. Bu noktada kısa ömürlü access token ve rotasyona tabi refresh token ikilisi, hem kullanıcı deneyimini hem de güvenlik seviyesini dengeler.
Devamı...
Mikroservis mimarisinde bir isteğin kaç farklı servisten geçtiğini takip etmek bile bazen dedektiflik gerektirir. Güvenlik açısından daha kritik soru ise şudur: Bu servisler gerçekten birbirleriyle konuştuğunu sandıkları servisler mi? Servis ağı (service mesh), uygulama kodunu güvenlik ve ağ politikalarıyla şişirmeden bu sorunu çözmek için tasarlanır. Istio ve Linkerd; şifreleme, kimlik doğrulama, yetkilendirme, gözlemlenebilirlik ve trafik yönetimini altyapı katmanına taşır.
Devamı...
Modern servisler yalnızca istek alıp JSON döndüren yapılardan ibaret değil: canlı konum, borsa verisi, oyun olayları ve telemetri akışları sürekli iletişim bekliyor. Bu noktada gRPC’nin HTTP/2 üzerinde çalışan streaming modeli, REST’in klasik istek-cevap ritmine güçlü bir alternatif sunar. Ancak “gRPC her zaman hızlıdır” demek yerine; gecikme, mesaj boyutu, eşzamanlı bağlantı ve iş yükü türü üzerinden ölçüm yapmak gerekir.
Devamı...
GraphQL, istemciye ihtiyacı olan veriyi seçme özgürlüğü verir; fakat bu esneklik resolver katmanında gizli bir maliyet doğurabilir. Kullanıcıları ve her kullanıcının gönderilerini listeleyen basit bir sorgu düşünün: kullanıcılar için bir sorgu, ardından her kullanıcı için ayrı gönderi sorgusu çalışır. Veri tabanı açısından masum görünen bu akış, kullanıcı sayısı arttıkça bir sorgu fırtınasına dönüşür. İşte bu klasik N+1 problemidir.
Devamı...
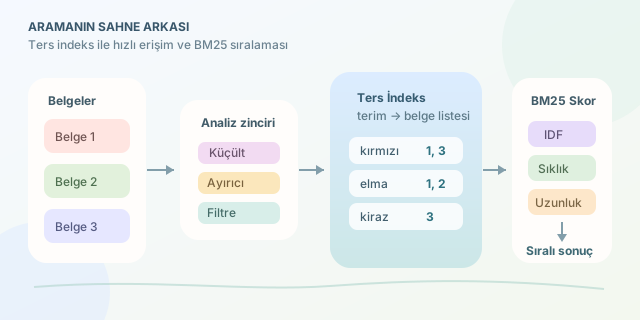
Elasticsearch, milyonlarca belge arasında milisaniyeler içinde arama yapabilmesini büyük ölçüde ters indeks (inverted index) adlı yapıya borçludur. Klasik bir veritabanında “bu belgenin içinde hangi kelimeler var?” sorusu öne çıkarken, ters indeks “bu kelime hangi belgelerde geçiyor?” sorusunu merkeze alır. Arama motoru dünyasının sihirbaz şapkası tam olarak budur.
Devamı...
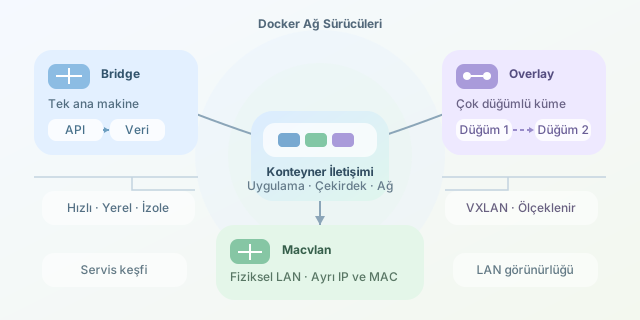
Docker’da ağ sürücüsü seçmek, sadece konteynerlere IP dağıtmak değildir; erişim sınırlarını, servis keşfini, gecikmeyi ve altyapının ölçeklenme biçimini belirler. Aynı uygulamanın yerel bir makinede, çok düğümlü bir kümede veya fiziksel ağda görünür olması gerektiğinde farklı sürücüler anlam kazanır. Bu yazıda bridge, overlay ve macvlan sürücülerini küçük ama tekrarlanabilir deneylerle karşılaştıralım.
Devamı...
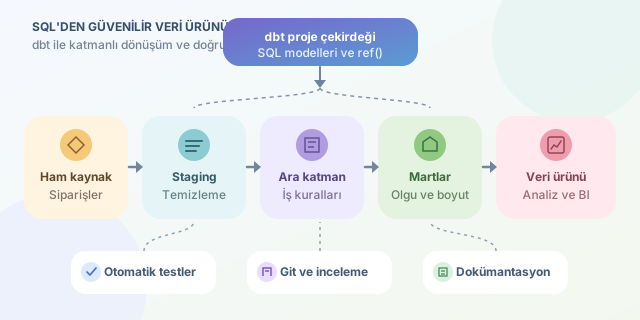
Modern veri ekiplerinde asıl zorluk, veriyi depoya taşımaktan çok onu güvenilir, anlaşılır ve yeniden üretilebilir biçimde dönüştürmektir. dbt (data build tool), bu problemi SQL dönüşümlerini yazılım geliştirme disiplinleriyle birleştirerek çözer. Böylece karmaşık ETL betikleri yerine Git ile izlenen modeller, testler, dokümantasyon ve bağımlılık grafikleriyle yönetilen bir veri platformu elde edersiniz.
Devamı...
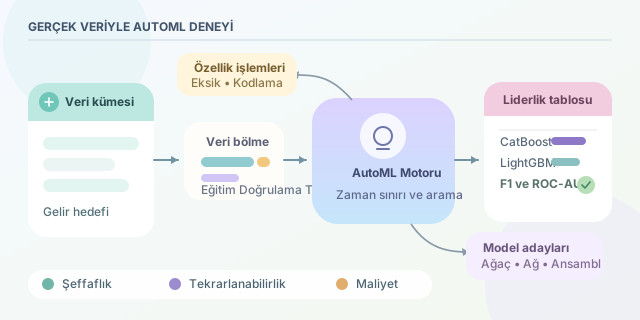
AutoML araçları, makine öğrenmesini “veriyi ver, sihri izle” düzeyine indirgeyen kutular değildir; iyi kullanıldıklarında veri hazırlama, özellik dönüşümü ve model arama süreçlerini sistematik biçimde hızlandırırlar. Ancak bir aracın gerçekten başarılı olup olmadığını anlamanın tek yolu, onu belirli bir veri setinde şeffaf ve tekrarlanabilir bir deneyle test etmektir. Buradaki amaç yalnızca en yüksek skoru bulmak değil, aracın hangi özellikleri faydalı gördüğünü ve hangi model ailesini neden seçtiğini değerlendirmektir.
Devamı...
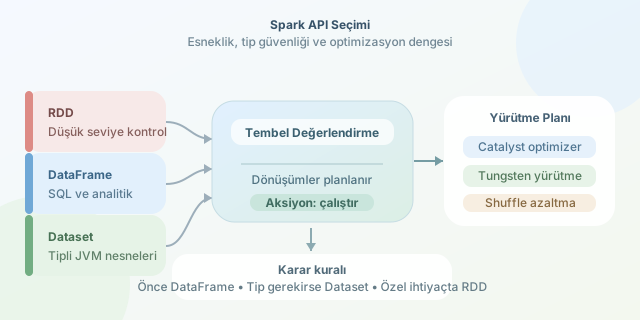
Apache Spark geliştiren herkesin karşısına aynı üçlü çıkar: RDD, DataFrame ve Dataset. Üçü de dağıtık veri işlemenin farklı yüzleridir; ancak soyutlama seviyesi yükseldikçe kod yazma deneyimi, tip güvenliği ve sorgu optimizasyonu da değişir. Doğru API seçimi yalnızca birkaç milisaniye kazanmak değildir: ekibin bakım maliyetini, hata ayıklama süresini ve küme kaynaklarının verimli kullanımını doğrudan etkiler.
Devamı...
Bir fabrikanın sıcaklık sensörlerini düşünün: cihazlar her 10 saniyede bir ölçüm üretir, ancak Wi-Fi kopmaları, mobil ağ gecikmeleri ve cihaz tamponları nedeniyle kayıtlar Flink’e kronolojik sırayla ulaşmaz. İşleme zamanına güvenmek, örneğin 10:00:05’te üretilen ama 10:00:40’ta gelen kritik bir sıcaklık artışını yanlış pencereye koyabilir. Apache Flink’in event-time yaklaşımı, olayın sisteme geliş anını değil, olayın gerçekten gerçekleştiği anı merkezine alır.
Devamı...
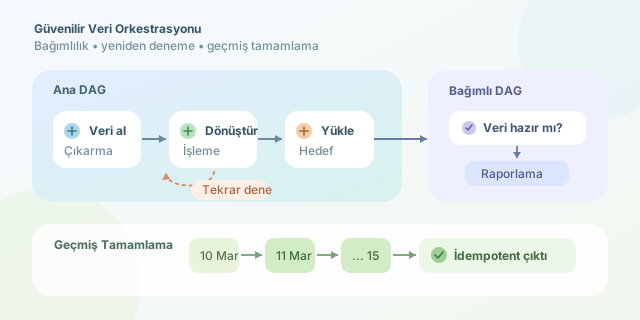
Veri boru hatları, tek seferlik çalışan betiklerden çok daha fazlasıdır: Her sabah veriyi çekmek, dönüştürmek, raporlamak ve olası aksaklıklarda sistemi güvenle toparlamak gerekir. Apache Airflow, bu süreci DAG (Directed Acyclic Graph — yönlü döngüsüz grafik) yaklaşımıyla yönetir. Her görev bir düğüm, görevler arasındaki sıralama ise bir yönlü kenardır. “Döngüsüz” olması önemlidir; A görevi B’yi, B de tekrar A’yı beklerse orkestrasyon sonsuza dek kahve molasına çıkar.
Devamı...
Bir kredi kartı işlemi, sunucu metriği veya üretim hattındaki sensör verisi normal davranıştan uzaklaştığında alarm vermek isteriz. Ancak etiketli “sahte” ya da “arıza” örnekleri çoğu zaman azdır. İşte bu noktada denetimsiz ve yarı denetimli anomali tespiti yöntemleri devreye girer. Isolation Forest (IF) ve One-Class SVM (OCSVM), aynı hedefe ulaşırken dünyayı oldukça farklı yorumlayan iki güçlü araçtır.
Devamı...